Минутка RTX 5060 Ti 16GB и 4-бит кванты Qwen3.8-27B
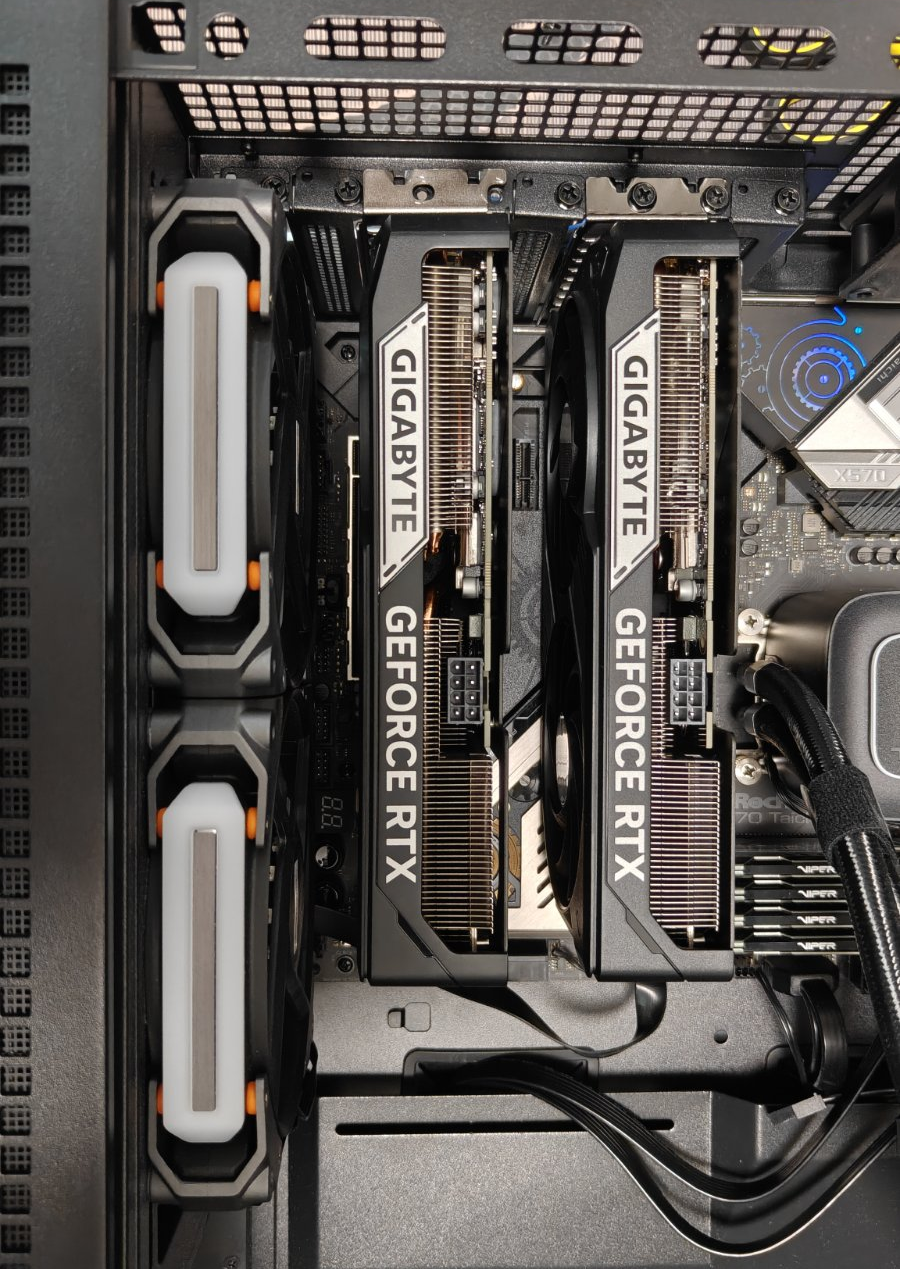
В лаборатории есть отдельные классы задач — генерация картинок и работа с RAG, которые не хочется перекладывать на дорогие GPU, т. к. задача решается куда меньшими ресурсами. По этому случаю еще летом была куплена пара RTX 5060 Ti 16GB и до них наконец-то дошли руки.
В генерации и RAG сегодня видеокарты смотреть не будем, но попробуем посмотреть, есть ли смысл использовать их как практически самый дешевый, несмотря ни на что, способ работать с полноценным Qwen3.8-27B локально. Одна карта сегодня стоит около 81-83 тысяч рублей. На рынке есть еще Radeon 9060XT 16GB, который теоретически стоит 75 тысяч, но у него существенно медленнее память (GDDR6 против GDDR7 у RTX) и при всей любви к Radeon, поддержка софтом для генерации картинок куда хуже. Плюс нативная поддержка FP4 форматов с имеющимся объемом памяти это большое преимущество. Поэтому опускаться ниже 5060 Ti 16GB для LLM уже некуда.
Заодно, автор собрал стенд на Threadripper, который позволяет тестировать видеокарты в любых сочетаниях без ограничения по шине. В итоге сегодня у нас в тестировании 2 платформы:
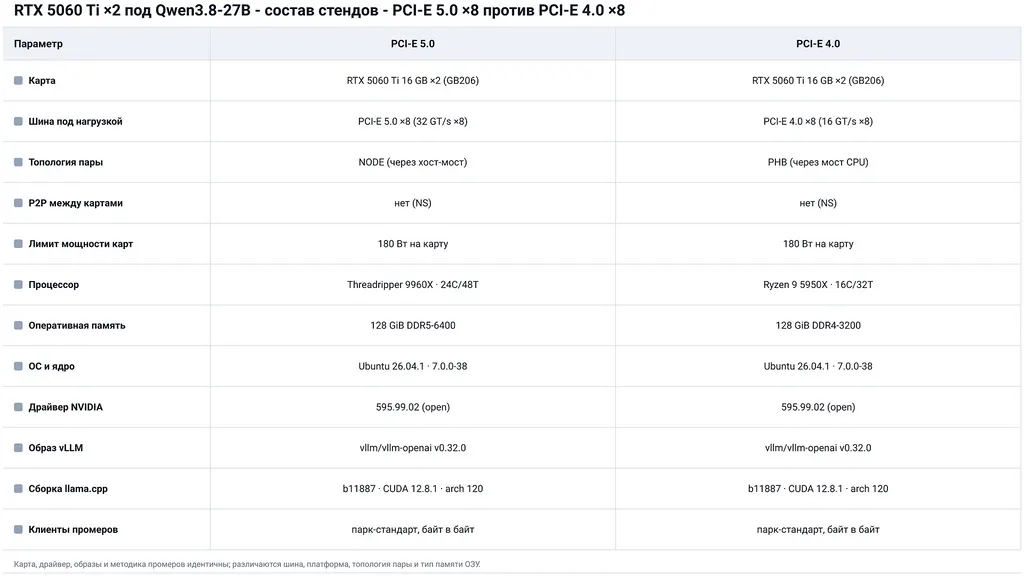
Платформа на Threadripper выступает как референс того, что в принципе можно получить от железа сегодня, однако, очевидно, что из-за стоимости компонентов это не целевая платформа для среднебюджетных GPU.
А вот вторая машина на Ryzen 9 5950X c DDR4 это как раз максимум того, что можно получить от платформ предыдущего поколения, которое более-менее доступно сегодня по деньгам для сборки, в том числе с учетом комплектующих с Авито. Более того, именно так автор эту машину и собирал. Если процессор еще вполне себе продается, то оперативная память и материнская плата ASRock X570 Taichi куплены через онлайн-барахолку по очень сладким ценам.
Что еще важно — 5060 Ti имеет только 8x PCI-E, что является особенностью карты. Физически разъем выполнен как 16x, но сама карта не использует всю пропускную полосу. Конкретно в тесте участвуют чуть разогнанные карты GeForce RTX™ 5060 Ti WINDFORCE MAX OC 16G, обладающие 2-мя достоинствами: наличие по минимальной цене в любом DNS и тихое охлаждение на 2 вентилятора. В остальном, минимальный заводской разгон никак не влияет на результаты.
Еще важно то, что P2P между картами не активируется из-за ограничений драйвера Nvidia. Изучать тему обхода этого ограничения автор не стал, хотя теоретически можно что-то выиграть. Софт на машинах полностью идентичен. Тестируются всегда 2 карты, т. к. задача использовать 27B не ниже 4-бит. В целом, какой-нибудь 3-бит UD-Q3_K_XXS запускается и на одной карте, но тут уже будут явные компромиссы по качеству:
| Конфигурация | С MTP | Без MTP | Прирост |
|---|---|---|---|
| C=1, temp 1,0 | 46,9 | 32,0 | +47 % |
| C=1, temp 0 | 48,9 | 32,0 | +53 % |
| C=2 | 32,3 на клиента | 27,9 на клиента | +18 % |
| C=4 | 22,9 на клиента | 20,4 на клиента | +9 % |
Условия: llama.cpp build 10851 (коммит 67672dc5b, CUDA 13.3, драйвер 595.84 open), ctx 65 536, KV q8_0 + FA, MTP draft 2 (из старых замеров). С контекстом в 64к что-то делать уже можно, но не особо комфортно, если быть честным, хотя скорость в один поток пригодна для небольших задач.
Но вернемся к целевой конфигурации и в начале посмотрим, какой контекст можно использовать не уходя ниже 4 бит:
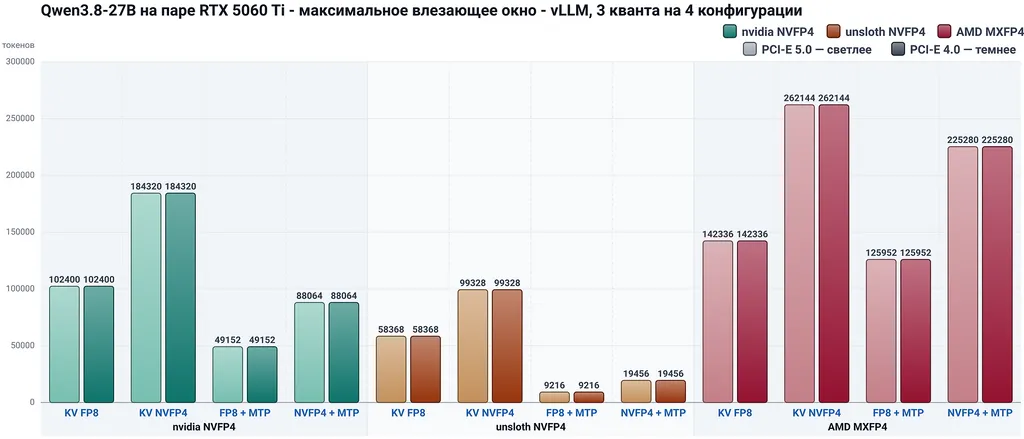
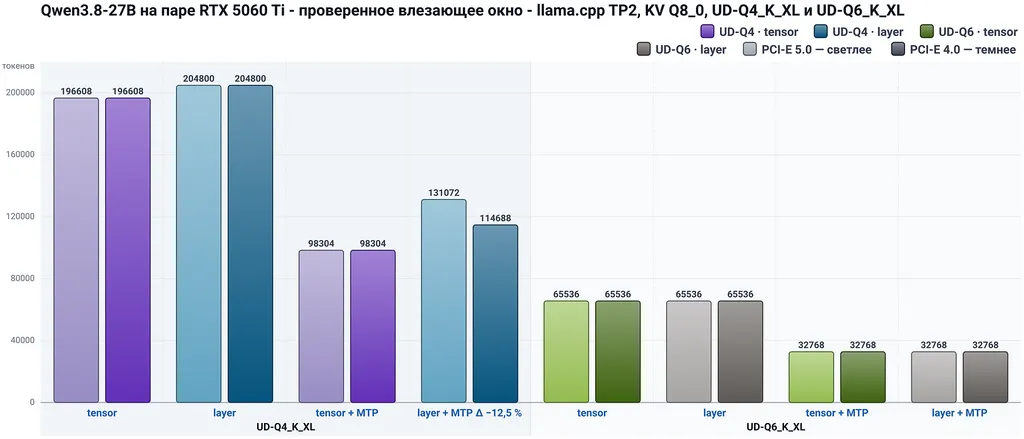
Если не считать странной флуктуации в llama.cpp на UD-Q4_K_XL с разделением по слоям (layer) с MTP, то объем памяти у двух разных платформ абсолютно идентичен, что и так ожидалось.
Что не очень хорошо, уместить полный 256К кэш (262144 токена) из всех возможных конфигураций, с MTP не получится ни в каком варианте. Чем-то придется жертвовать и, например, соглашаться на 225К кэша для сочетания MXFP4 + NVFP4 кэш, что вполне комфортно.
Однако, во всех случаях vision у модели был включен. Т.е. где-то по 0,88 GB VRAM на каждой карте занято зрением. Если бы у нас был один 32GB GPU, то дублирования бы не происходило и vision грузился бы только один раз. Рантаймы позволяют его отключить и выиграть контекст. Для примера, чтобы сравнить с потреблением памяти на полный 256К контекст:
| Формат KV | Цена токена | 262 144 токена | Где возможен |
|---|---|---|---|
| FP16 (f16) | ≈ 32 КиБ | ≈ 8,00 ГиБ | vLLM, llama.cpp, поведение по умолчанию |
| Q8_0 | ≈ 17 КиБ | ≈ 4,25 ГиБ | llama.cpp — все тесты GGUF |
| FP8 (fp8) | 16,6 КиБ | ≈ 4,15 ГиБ | только vLLM (--kv-cache-dtype fp8) |
| NVFP4 (nvfp4) | 9,65 КиБ | ≈ 2,41 ГиБ | только vLLM (--kv-cache-dtype nvfp4) |
Видно, что отключение зрения резко улучшит ситуацию для адекватных 8-бит вариантов KV-кэша. Т.е. вполне интересным станет вариант NVFP4 кванта с любым вариантом кэша. А MXFP4 квант уже будет ничем не ограничен. Отключать ли зрение вопрос интересный. Автор, например, регулярно заставляет модели смотреть своими глазами на результат работы, например на те же графики внутри данной статьи.
Интересен так же вопрос производительности. В начале без MTP:
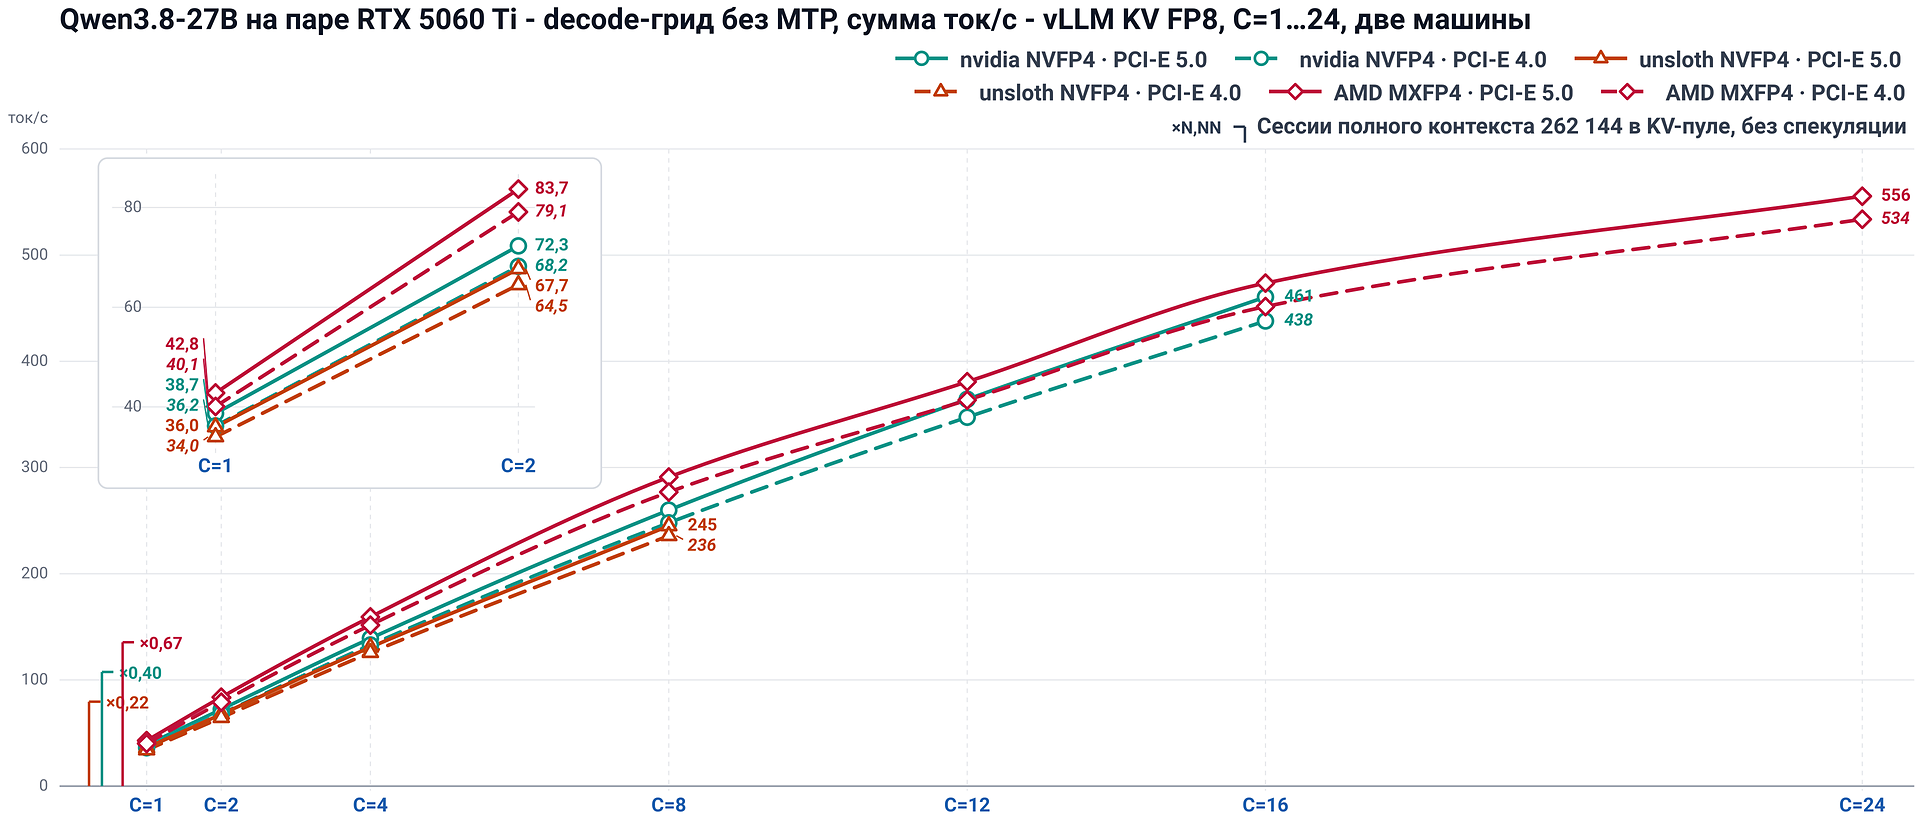
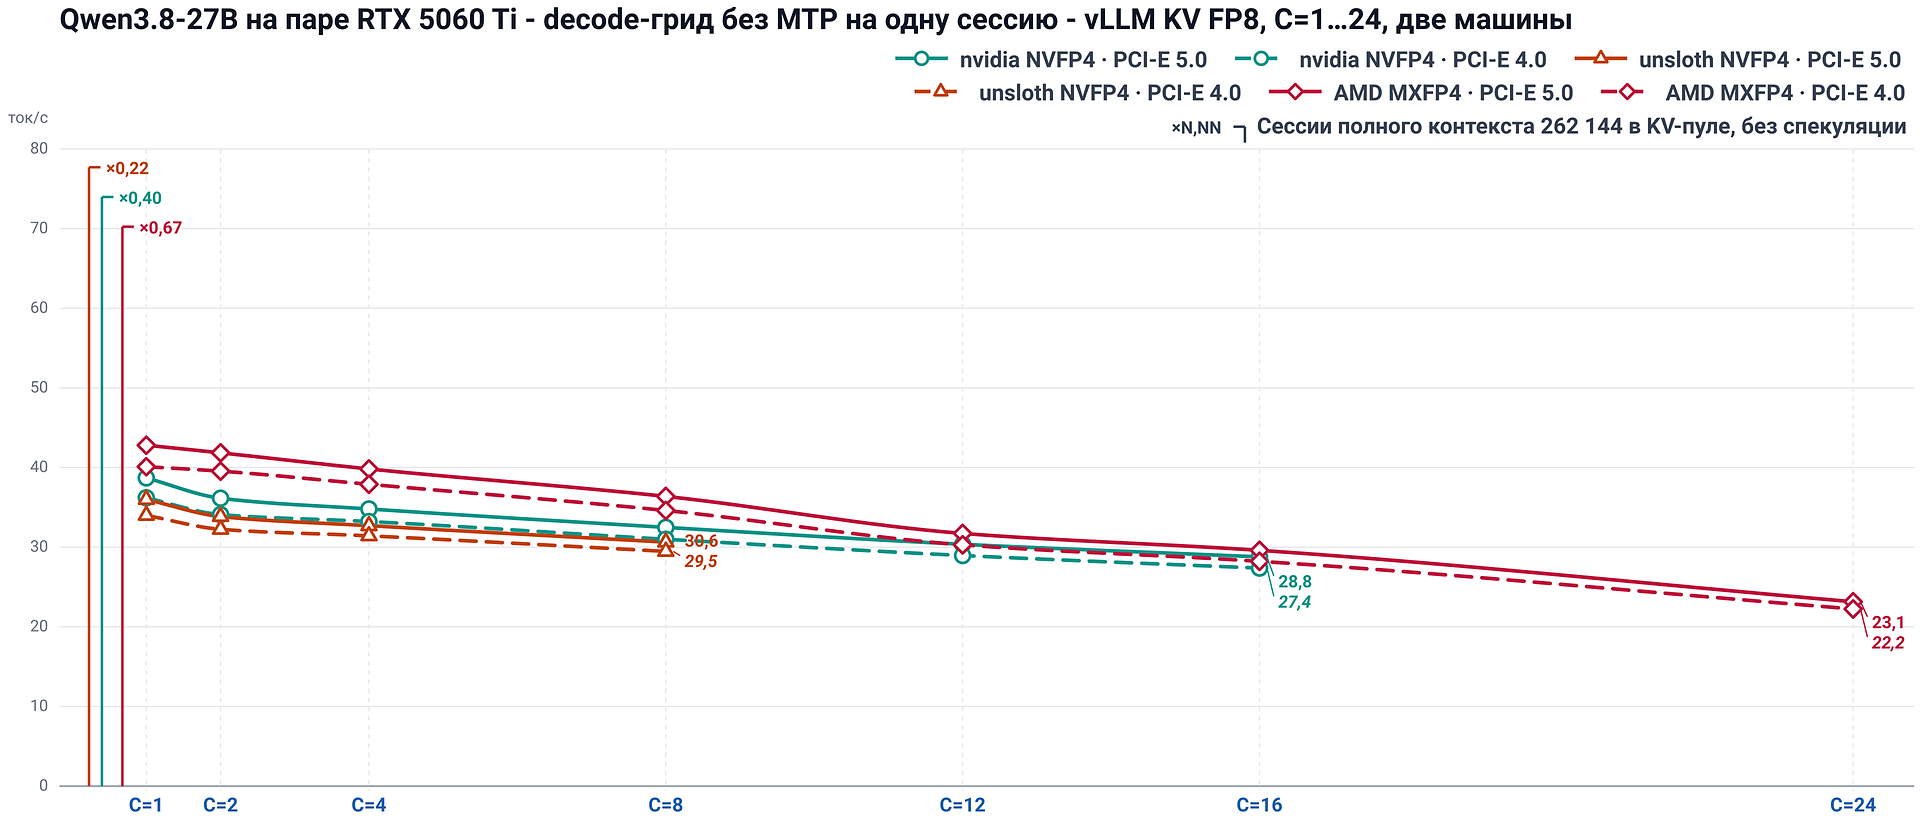
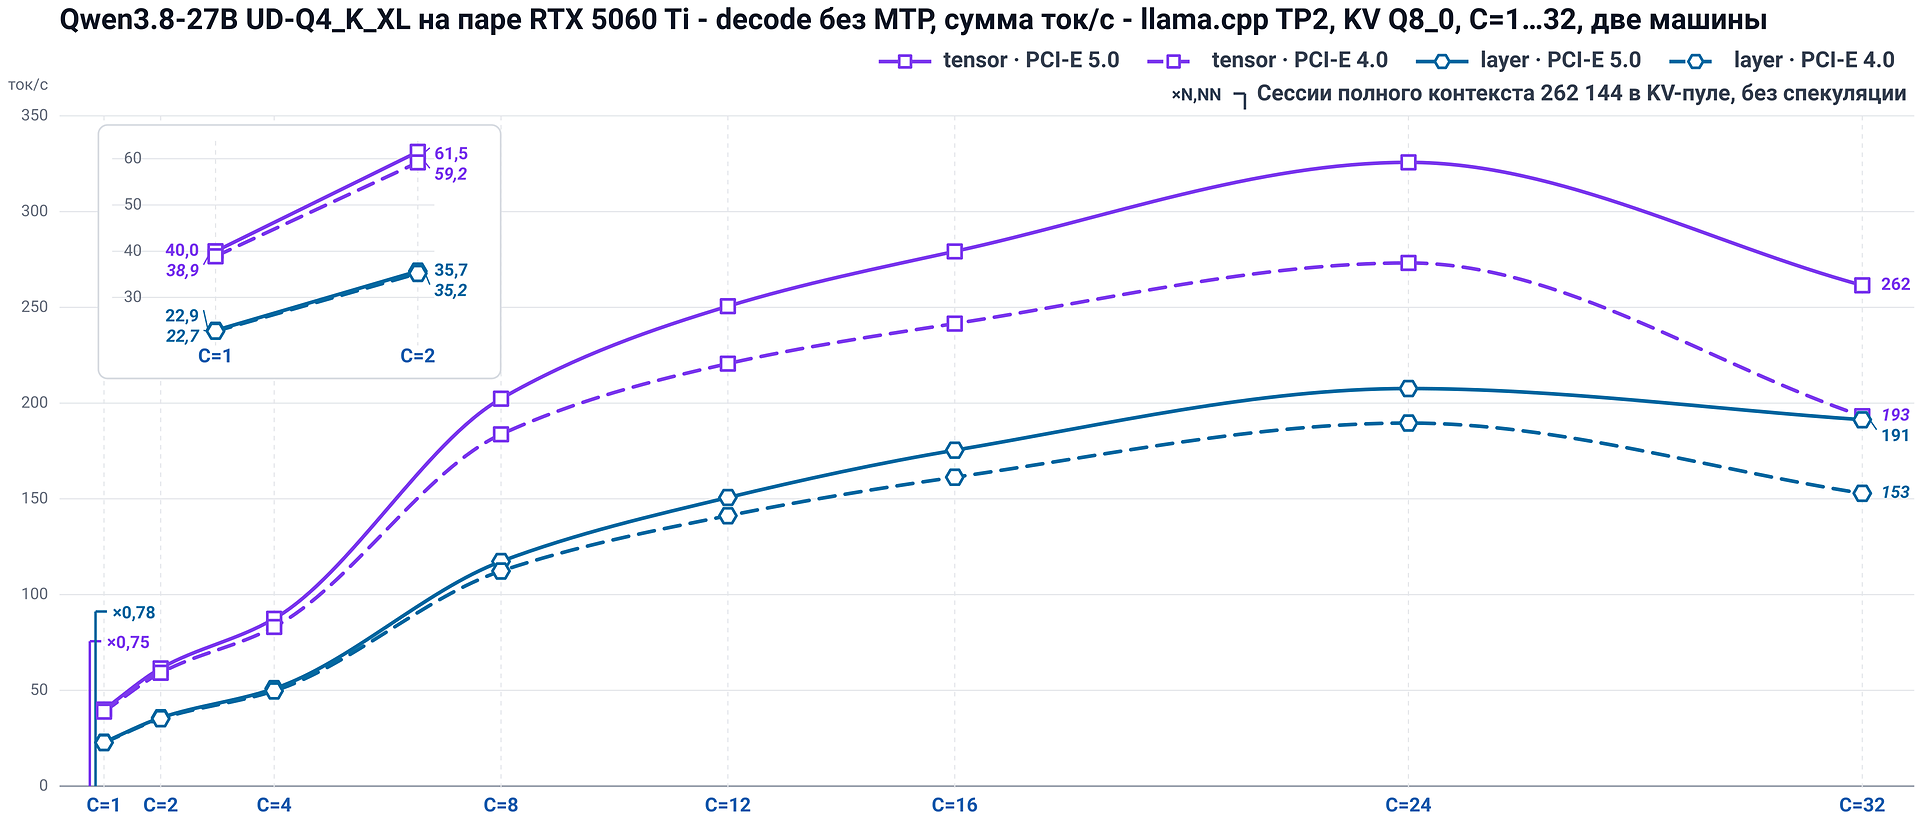
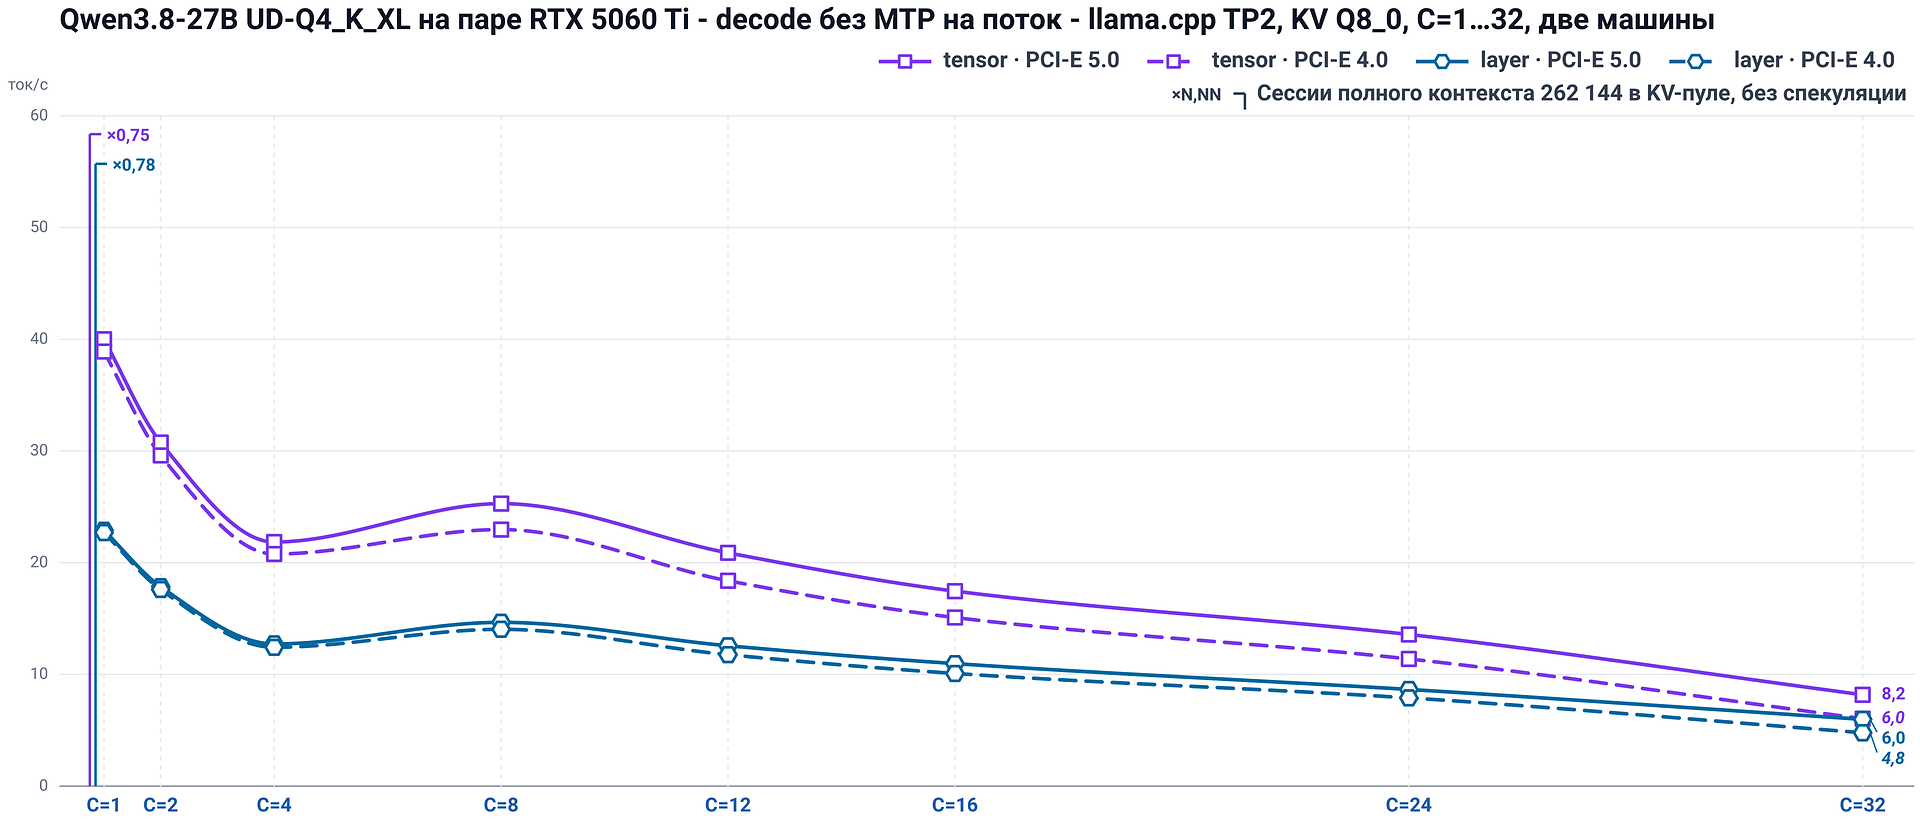
Картинка без MTP для 5060 Ti выглядит не особо интересно. Около 40 ток/с в один поток на пустом контексте. Попробовать можно, но не комфортно. Пойдем сразу в вариант с MTP:
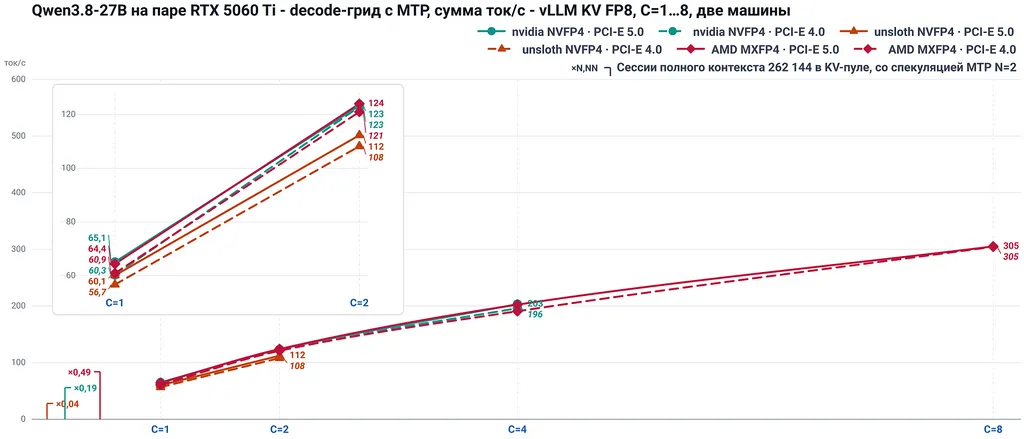
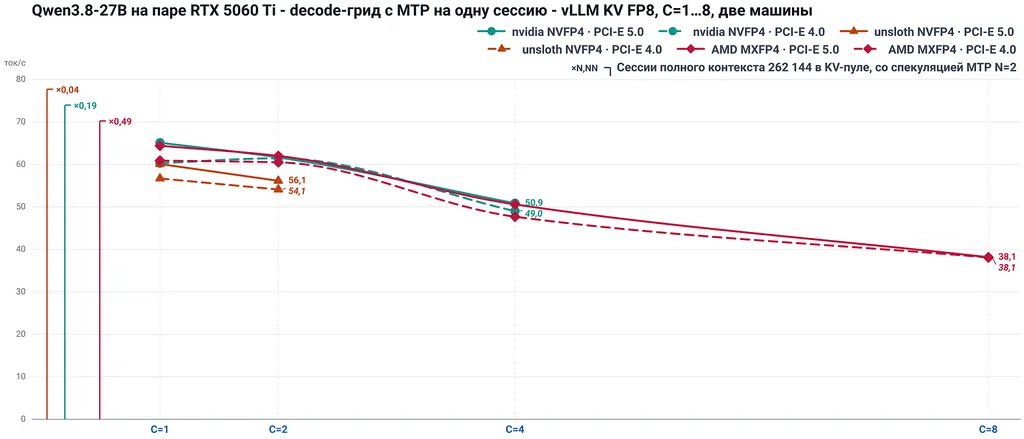
С MTP в vLLM картинка уже куда интереснее. Более 60 токенов в секунду в один поток и, если есть необходимость и возможность обойтись более короткими контекстами, то и на 2-х потоках уже приемлемые 55 токенов в секунду. Разницы между старым декстопом и новым сервером практически нет.
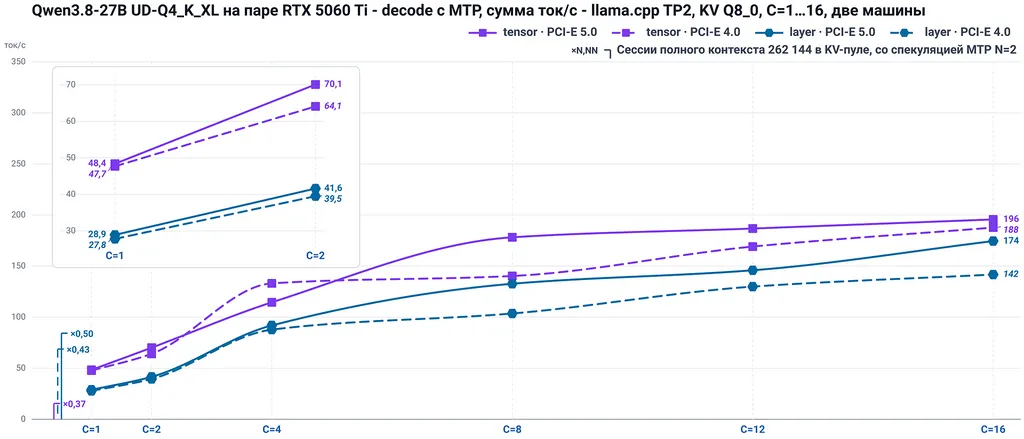
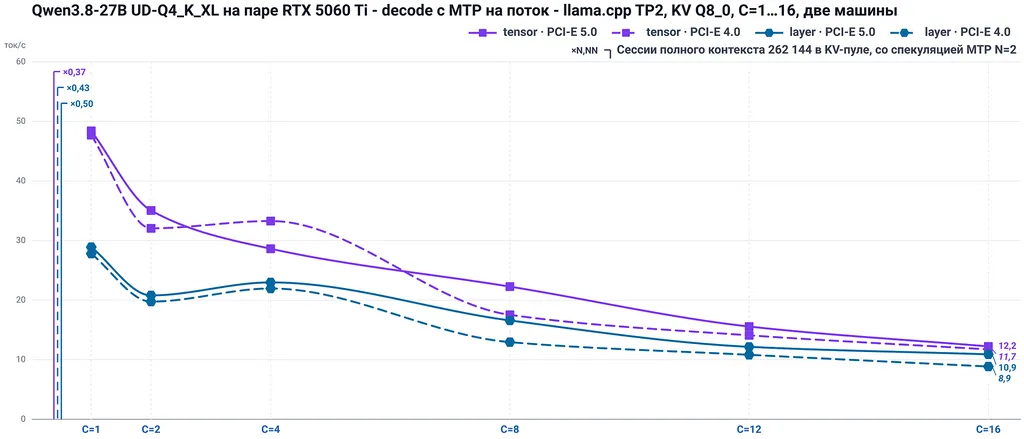
В llama.cpp, ожидаемо, картинка чуть похуже, но в варианте со split mode = tensor можно получить под 50 токенов в секунду, но, конечно, vLLM тут побеждает. Опять же, выигрыш от PCI-E 5.0 совершенно не стоит разницы в стоимости платформы.
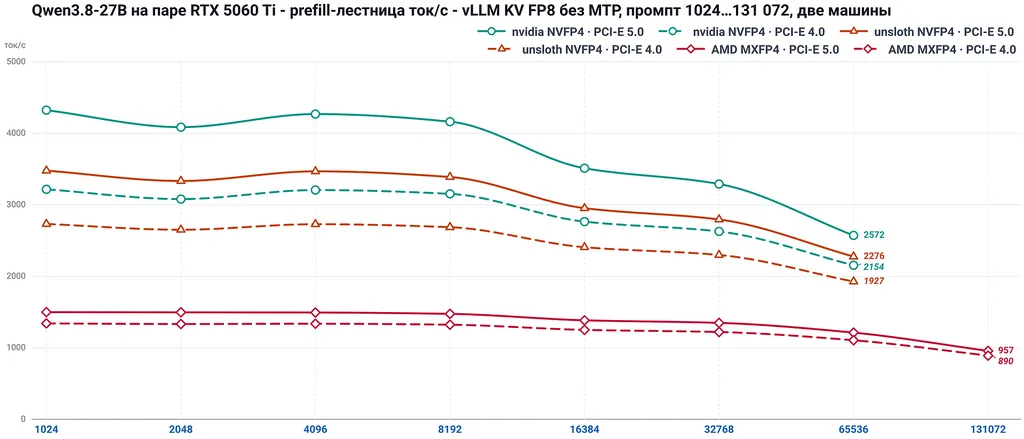
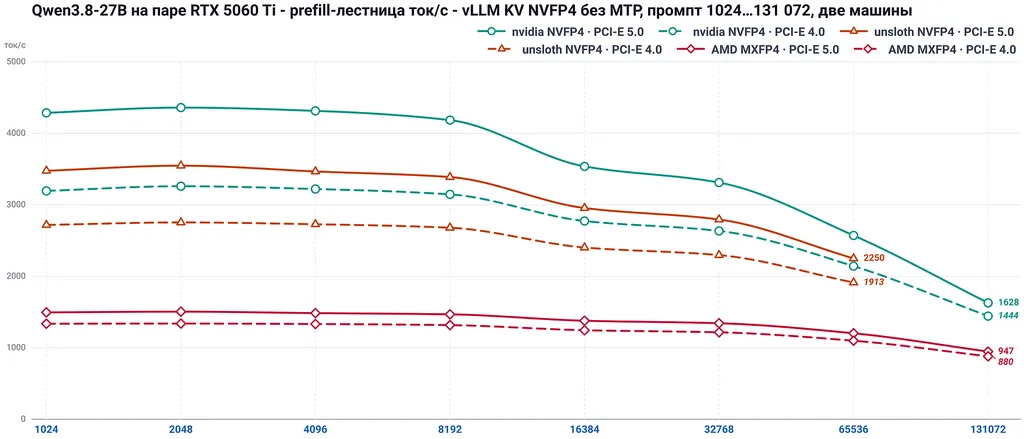
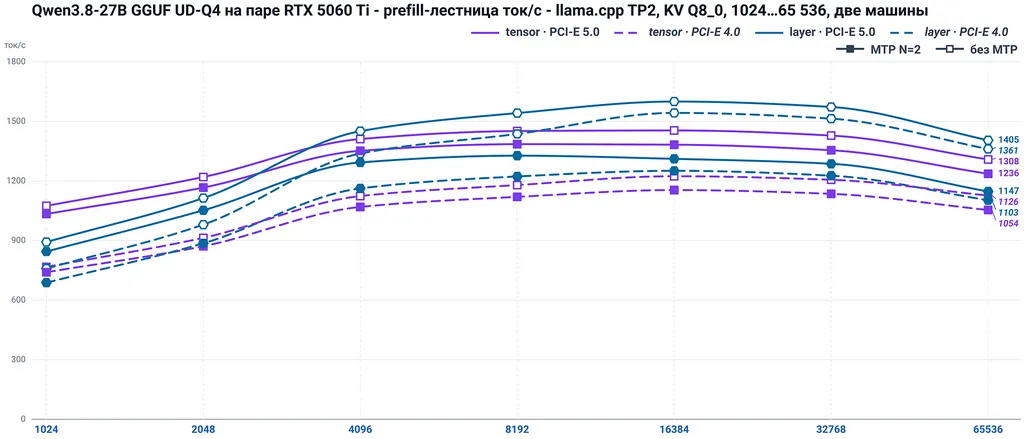
А вот с prefill, т. е. чтением промптов все гораздо интереснее. Во-первых, тут в vLLM где-то на 25-30% выигрывает более новая платформа. Во-вторых, видна цена за объем контекста в MXFP4 — больше места, но платим скоростью decode (тут причина до конца не ясна, но вероятно блоки карт могут аппаратно работать только с NVFP4). В-третьих, в llama.cpp decode неожиданно ускоряется с ростом контекста, хотя на абсолютных значениях это примерно тот-же MXFP4.
Итоги сравнения в разных разрезах PCI-E 4.0 и 5.0:
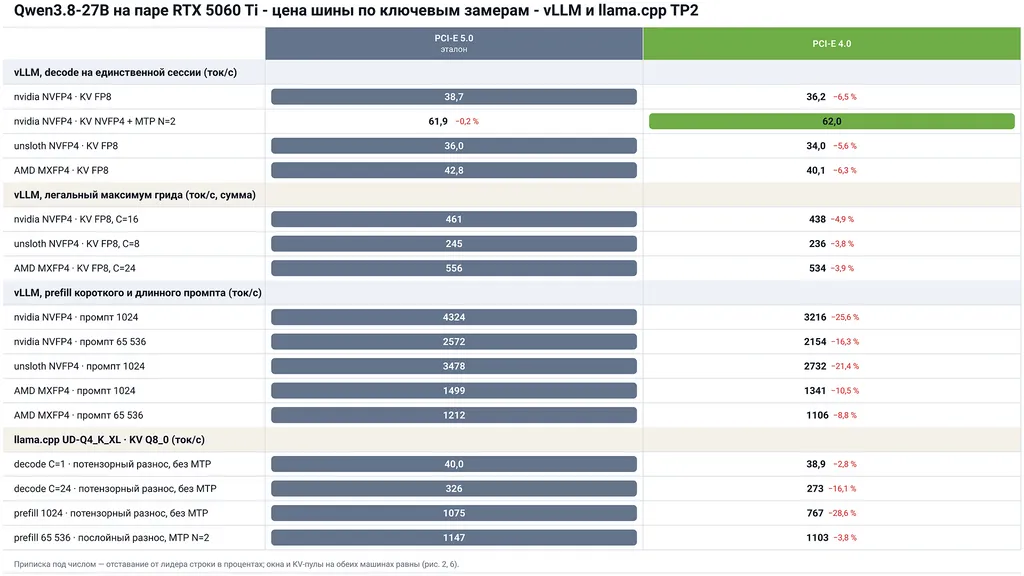
Если не считать точечной аномалии с NVFP4 квантом и кэшом в VLLM, decode на более быстрой шине где-то на 5-7% быстрее. Разница же в prefill от 10% до 30% и более.
Если оторваться от процентов, то для задачи работы в одно лицо на рабочей станции нет принципиальной разницы между поколениями платформы. Разница в prefill в один поток просто не будет ощущаться из-за масштабного кэширования, а decode на самом деле колеблется в рамках погрешности. 5% невозможно почувствовать на глаз. В принципе, для полноты картины можно было бы посмотреть еще современный десктоп на DDR5, но с 2x PCI-E 5,0×8, т. е. материнскую плату на AMD X870E вместе с топовым Ryzen 9, но практического смысла нет, т. к. результат бы практически не отличался от Threadripper или был бы чуть выше за счет скорости ядер игрового GPU с X3D, если бы кто-то действительно собрал такую конфигурацию под пару 5060 Ti. Реалистично, любая платформа на DDR5 сегодня стоит столько, что нет никакого смысла брать ее под бюджетную ИИ сборку.
Что касается общего результата — две карты 5060Ti 16GB действительно можно использовать с Qwen3.8-27B в 4-бит кванте модели и 8-бит кэшем или разогнать контекст за счет поддержки NVFP4 кэша начиная с vLLM 0.32.0. Если сравнивать с 32GB GPU в виде Radeon R9700 или RTX PRO 4500, то 165 тысяч рублей против 400-450 и 600-630 тысяч соответственно (на момент написания статьи) дадут примерно тот же уровень производительности, но в 3-4 раза дешевле. Т.е. конфигурация может иметь смысл. Особенно интересным может быть вариант со старым Xeon или Threadripper на бытовой DDR4, которые дадут собрать 4 карты в сборке. 64GB уже позволят замахнуться на Qwen3.8-Flash-Next с небольшой динамической выгрузкой экспертов, что даст уже другой уровень качества модели и, как ни странно, большую скорость.
Но, конечно, назвать это бюджетной сборкой уже не получится. Рост цен на GPU и не собирается останавливаться.
