В лаборатории есть отдельные классы задач — генерация картинок и работа с RAG, которые не хочется перекладывать на дорогие GPU, т. к. задача решается куда меньшими ресурсами. По этому случаю еще летом была куплена пара RTX 5060 Ti 16GB и до них наконец-то дошли руки.
В генерации и RAG сегодня видеокарты смотреть не будем, но попробуем посмотреть, есть ли смысл использовать их как практически самый дешевый, несмотря ни на что, способ работать с полноценным Qwen3.8-27B локально. Одна карта сегодня стоит около 81-83 тысяч рублей. На рынке есть еще Radeon 9060XT 16GB, который теоретически стоит 75 тысяч, но у него существенно медленнее память (GDDR6 против GDDR7 у RTX) и при всей любви к Radeon, поддержка софтом для генерации картинок куда хуже. Плюс нативная поддержка FP4 форматов с имеющимся объемом памяти это большое преимущество. Поэтому опускаться ниже 5060 Ti 16GB для LLM уже некуда.
Заодно, автор собрал стенд на Threadripper, который позволяет тестировать видеокарты в любых сочетаниях без ограничения по шине. В итоге сегодня у нас в тестировании 2 платформы:

Платформа на Threadripper выступает как референс того, что в принципе можно получить от железа сегодня, однако, очевидно, что из-за стоимости компонентов это не целевая платформа для среднебюджетных GPU.
А вот вторая машина на Ryzen 9 5950X c DDR4 это как раз максимум того, что можно получить от платформ предыдущего поколения, которое более-менее доступно сегодня по деньгам для сборки, в том числе с учетом комплектующих с Авито. Более того, именно так автор эту машину и собирал. Если процессор еще вполне себе продается, то оперативная память и материнская плата ASRock X570 Taichi куплены через онлайн-барахолку по очень сладким ценам.
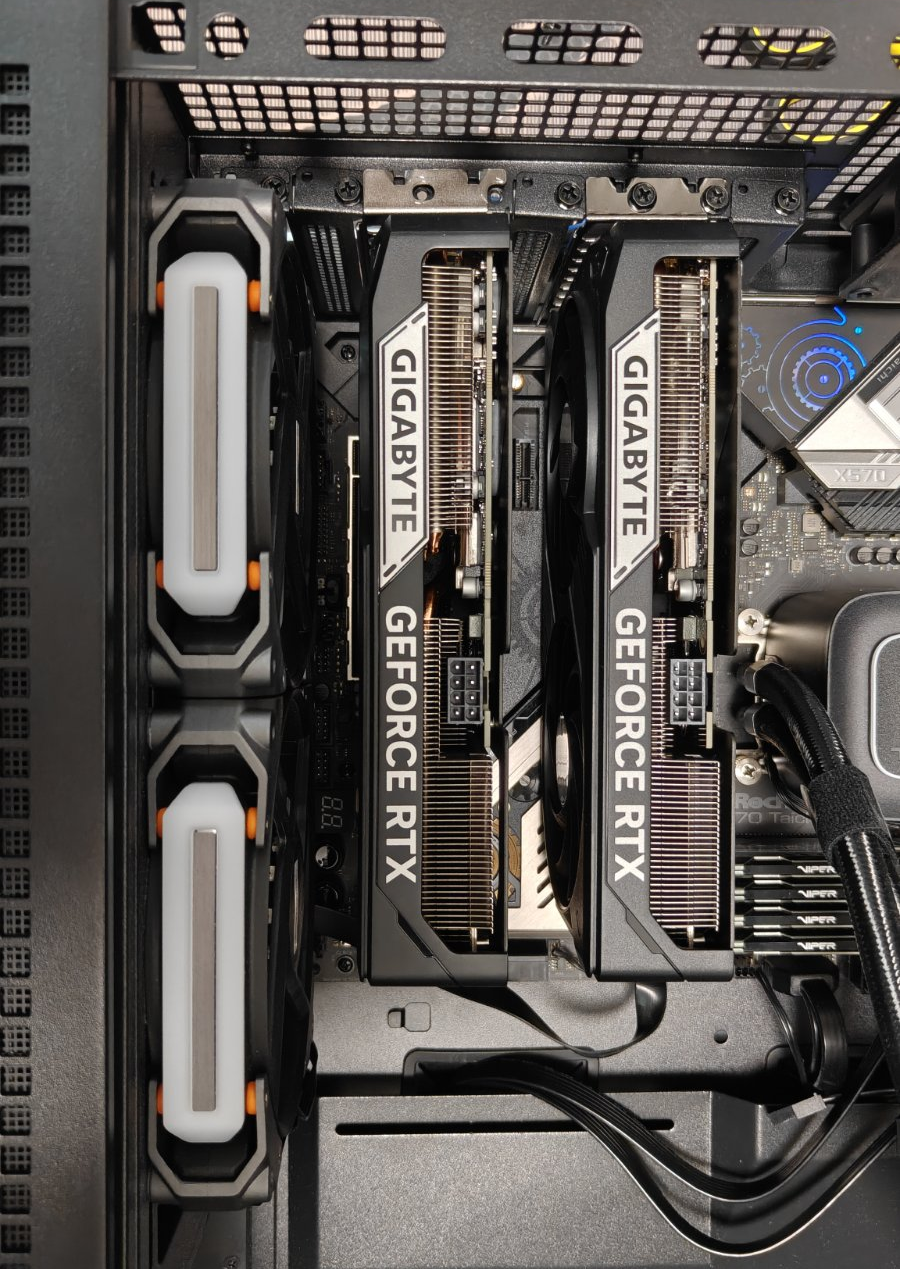
Что еще важно — 5060 Ti имеет только 8x PCI-E, что является особенностью карты. Физически разъем выполнен как 16x, но сама карта не использует всю пропускную полосу. Конкретно в тесте участвуют чуть разогнанные карты GeForce RTX™ 5060 Ti WINDFORCE MAX OC 16G, обладающие 2-мя достоинствами: наличие по минимальной цене в любом DNS и тихое охлаждение на 2 вентилятора. В остальном, минимальный заводской разгон никак не влияет на результаты.
Еще важно то, что P2P между картами не активируется из-за ограничений драйвера Nvidia. Изучать тему обхода этого ограничения автор не стал, хотя теоретически можно что-то выиграть. Софт на машинах полностью идентичен. Тестируются всегда 2 карты, т. к. задача использовать 27B не ниже 4-бит. В целом, какой-нибудь 3-бит UD-Q3_K_XXS запускается и на одной карте, но тут уже будут явные компромиссы по качеству:
| Конфигурация | С MTP | Без MTP | Прирост |
|---|---|---|---|
| C=1, temp 1,0 | 46,9 | 32,0 | +47 % |
| C=1, temp 0 | 48,9 | 32,0 | +53 % |
| C=2 | 32,3 на клиента | 27,9 на клиента | +18 % |
| C=4 | 22,9 на клиента | 20,4 на клиента | +9 % |
Условия: llama.cpp build 10851 (коммит 67672dc5b, CUDA 13.3, драйвер 595.84 open), ctx 65 536, KV q8_0 + FA, MTP draft 2 (из старых замеров). С контекстом в 64к что-то делать уже можно, но не особо комфортно, если быть честным, хотя скорость в один поток пригодна для небольших задач.
Но вернемся к целевой конфигурации и в начале посмотрим, какой контекст можно использовать не уходя ниже 4 бит:


Если не считать странной флуктуации в llama.cpp на UD-Q4_K_XL с разделением по слоям (layer) с MTP, то объем памяти у двух разных платформ абсолютно идентичен, что и так ожидалось.
В лаборатории есть отдельные классы задач — генерация картинок и работа с RAG, которые не хочется перекладывать на дорогие GPU, т. к. задача решается куда меньшими ресурсами. По этому случаю еще летом была куплена пара RTX 5060 Ti 16GB и до них наконец-то дошли руки.
В генерации и RAG сегодня видеокарты смотреть не будем, но попробуем посмотреть, есть ли смысл использовать их как практически самый дешевый, несмотря ни на что, способ работать с полноценным Qwen3.8-27B локально. Одна карта сегодня стоит около 81-83 тысяч рублей. На рынке есть еще Radeon 9060XT 16GB, который теоретически стоит 75 тысяч, но у него существенно медленнее память (GDDR6 против GDDR7 у RTX) и при всей любви к Radeon, поддержка софтом для генерации картинок куда хуже. Плюс нативная поддержка FP4 форматов с имеющимся объемом памяти это большое преимущество. Поэтому опускаться ниже 5060 Ti 16GB для LLM уже некуда.
Заодно, автор собрал стенд на Threadripper, который позволяет тестировать видеокарты в любых сочетаниях без ограничения по шине. В итоге сегодня у нас в тестировании 2 платформы:
Платформа на Threadripper выступает как референс того, что в принципе можно получить от железа сегодня, однако, очевидно, что из-за стоимости компонентов это не целевая платформа для среднебюджетных GPU.
А вот вторая машина на Ryzen 9 5950X c DDR4 это как раз максимум того, что можно получить от платформ предыдущего поколения, которое более-менее доступно сегодня по деньгам для сборки, в том числе с учетом комплектующих с Авито. Более того, именно так автор эту машину и собирал. Если процессор еще вполне себе продается, то оперативная память и материнская плата ASRock X570 Taichi куплены через онлайн-барахолку по очень сладким ценам.
Что еще важно — 5060 Ti имеет только 8x PCI-E, что является особенностью карты. Физически разъем выполнен как 16x, но сама карта не использует всю пропускную полосу. Конкретно в тесте участвуют чуть разогнанные карты GeForce RTX™ 5060 Ti WINDFORCE MAX OC 16G, обладающие 2-мя достоинствами: наличие по минимальной цене в любом DNS и тихое охлаждение на 2 вентилятора. В остальном, минимальный заводской разгон никак не влияет на результаты.
Еще важно то, что P2P между картами не активируется из-за ограничений драйвера Nvidia. Изучать тему обхода этого ограничения автор не стал, хотя теоретически можно что-то выиграть. Софт на машинах полностью идентичен. Тестируются всегда 2 карты, т. к. задача использовать 27B не ниже 4-бит. В целом, какой-нибудь 3-бит UD-Q3_K_XXS запускается и на одной карте, но тут уже будут явные компромиссы по качеству:
| Конфигурация | С MTP | Без MTP | Прирост |
|---|---|---|---|
| C=1, temp 1,0 | 46,9 | 32,0 | +47 % |
| C=1, temp 0 | 48,9 | 32,0 | +53 % |
| C=2 | 32,3 на клиента | 27,9 на клиента | +18 % |
| C=4 | 22,9 на клиента | 20,4 на клиента | +9 % |
Условия: llama.cpp build 10851 (коммит 67672dc5b, CUDA 13.3, драйвер 595.84 open), ctx 65 536, KV q8_0 + FA, MTP draft 2 (из старых замеров). С контекстом в 64к что-то делать уже можно, но не особо комфортно, если быть честным, хотя скорость в один поток пригодна для небольших задач.
Но вернемся к целевой конфигурации и в начале посмотрим, какой контекст можно использовать не уходя ниже 4 бит:
Если не считать странной флуктуации в llama.cpp на UD-Q4_K_XL с разделением по слоям (layer) с MTP, то объем памяти у двух разных платформ абсолютно идентичен, что и так ожидалось.