Минутка Nanbeige4.3-33B и flash моделей
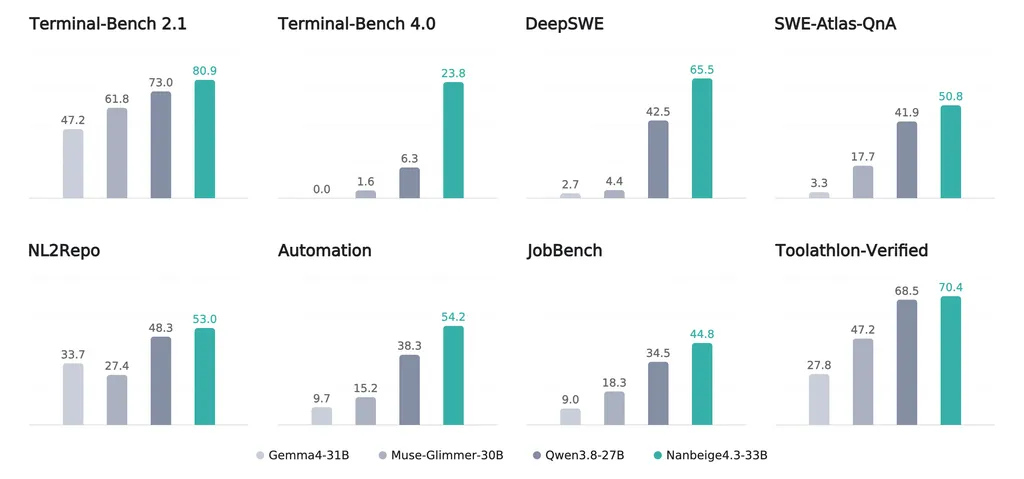
И так, новая модель от не очень известной команды. Если попросить алису описать разработчика и модель, получим следующее:
Nanbeige — это исследовательская команда по языковым моделям при китайской компании BOSS Zhipin, базирующаяся в Пекине. Лаборатория развивает семейство открытых моделей и известна в первую очередь компактными решениями: её небольшие модели на 3 млрд параметров (Nanbeige4.1-3B, Nanbeige4.2-3B) неоднократно удавалось вытянуть до уровня моделей, в разы более крупных, за счёт тщательного отбора данных, продуманного расписания обучения и дистилляции от более мощных «учителей».
Nanbeige4.3-33B — флагман и «teacher-модель» новой серии 4.3. Это плотная (dense) модель на 33 млрд параметров без MoE-трюков, с контекстным окном до 512 тыс. токенов и открытыми весами под Apache 2.0. Заявленная фишка — агентные задачи и сложное программирование: по бенчмаркам серии она обходит сопоставимые по размеру Qwen3.8-27B, Muse-Glimmer-30B и Gemma4-31B, на JobBench побеждает базовую модель в большинстве из 35 проверенных профессий, а на Terminal-Bench 2.1 разработчики сообщают 80,9%. Логика выпуска типична для команды: сначала мощный и при этом недорого в обслуживании агент, который потом станет основой для дистилляции возможностей в маленькие модели вроде будущей Nanbeige4.3-3B. В сообществе к результатам относятся с умеренным скепсисом — цифры считают правдоподобными, но предупреждают, что поведение модели может быть нестабильным на отдельных задачах.
Т.е. вроде бы не новая команда, есть история в области небольших моделей, поэтому есть смысл заняться хотя бы беглым исследованием.
Пока загружаются веса, посмотрим на сравнение новой модели с теми самыми Flash моделями, которые сейчас у всех на слуху.
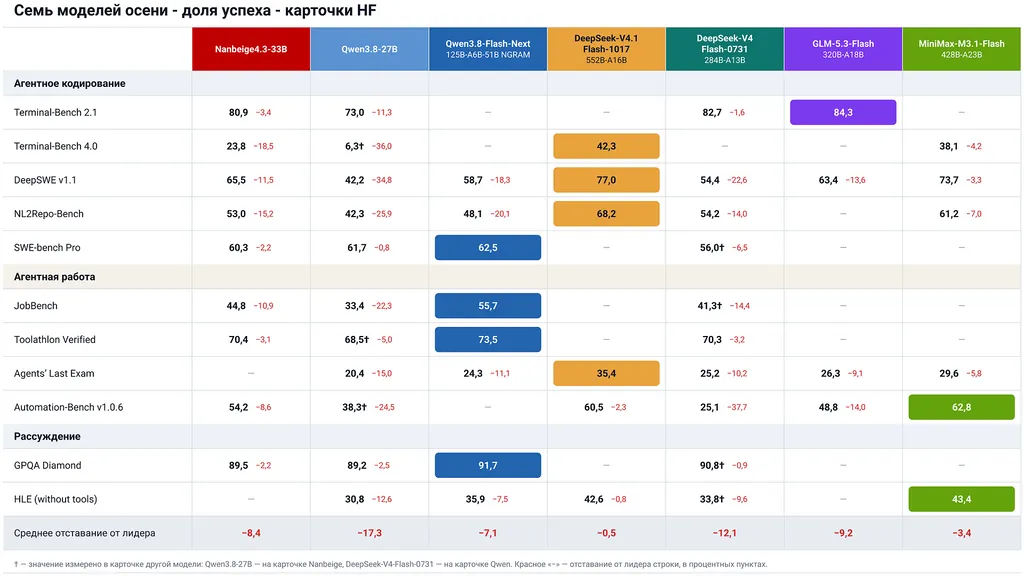
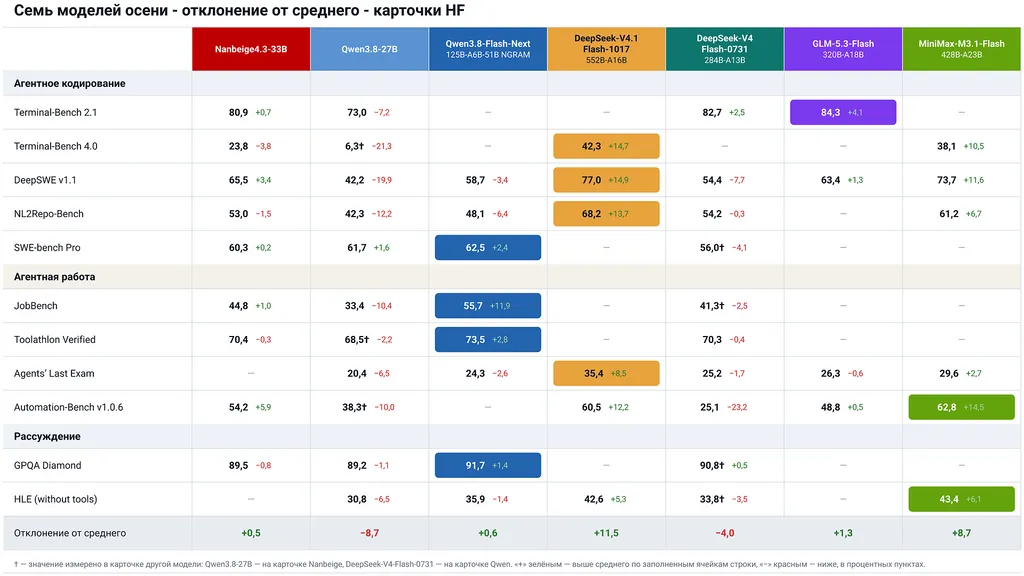
Если смотреть на заявленные метрики, то действительно в среднем по больнице мы получаем чемпиона dense моделей и уровень «средней» современной flash модели. Понятно, что тут все тесты из самих карточек моделей с Hugging Face, т. е.их достоверность это тема отдельного исследования. На Artificial Analysis новой модели нет ни в каком виде, но можно собрать альтернативное сравнение Flash моделей между собой:
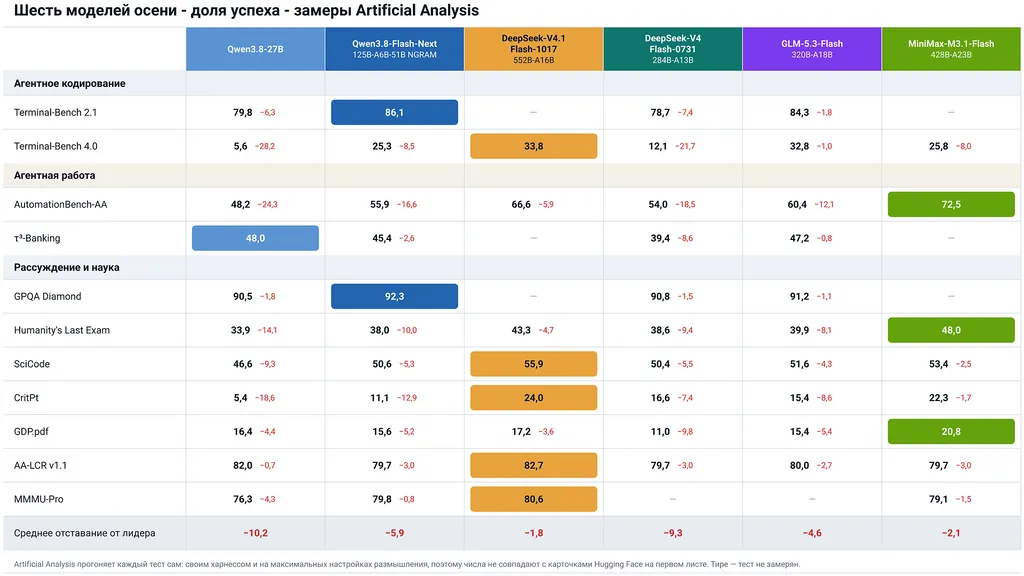
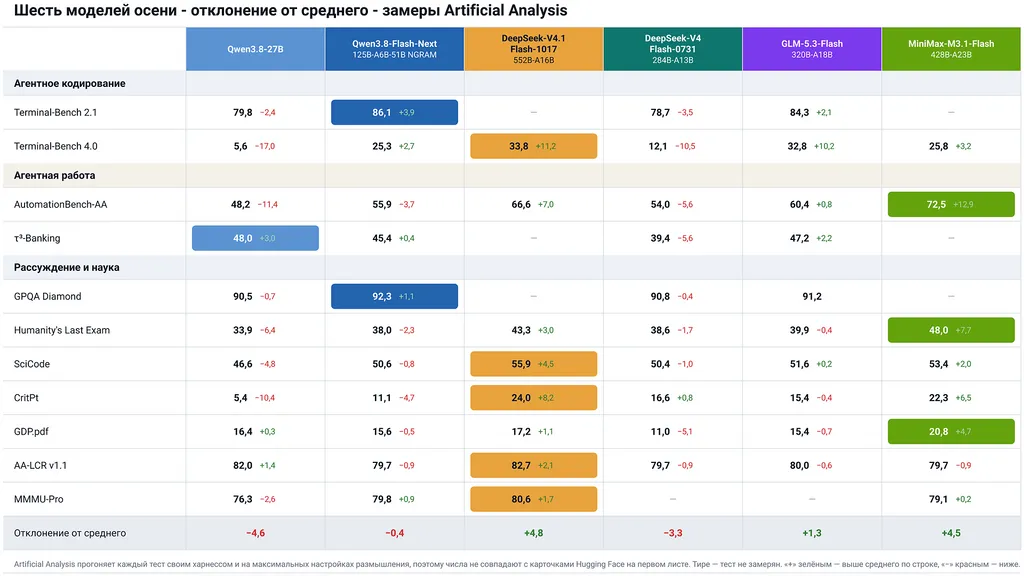
Принципиально тут картина не меняется. Qwen3.8-Flash-Next это «середина середин»:
- В нашей выборке это середина «по интеллекту»
- Середина по размеру. В другом размерном порядке от dense моделей, но куда меньше всех остальных flash
Тем не менее, Qwen3.8-Flash-Next тут однозначный чемпион по экономии ресурсов. Всего 6B активированных параметров. Если прикинуть «интеллект на массу», то получается крайне интересно:
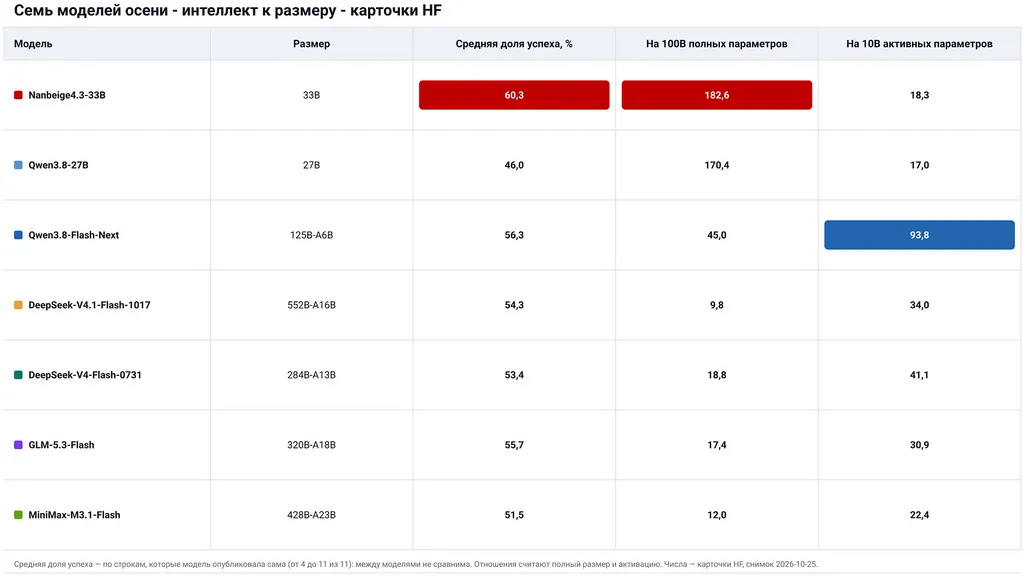
Qwen Flash тут побеждает интеллектом на активацию с огромным перевесом. Прирост от размера весов всех других flash моделей несопоставим с реальным ростом качества. Автор ожидает тут существенной перестановки в абсолютном рейтинге после выхода перспективной Qwen4.0-Flash.
Dense модели дают существенно большую отдачу к размеру по сравнению с любыми MoE моделями, но Nanbeige здесь просто чемпион по обещаниям. Сравнение, конечно, несколько теплого с мягким, но посмотрим на результаты быстрых тестов.
1. Генерация простого костра в лесу на HTML
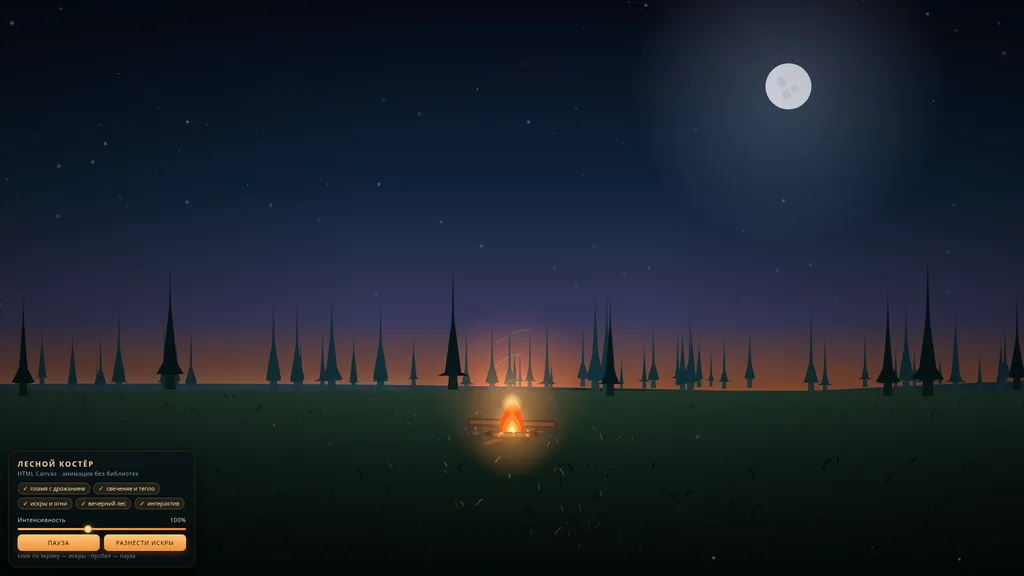
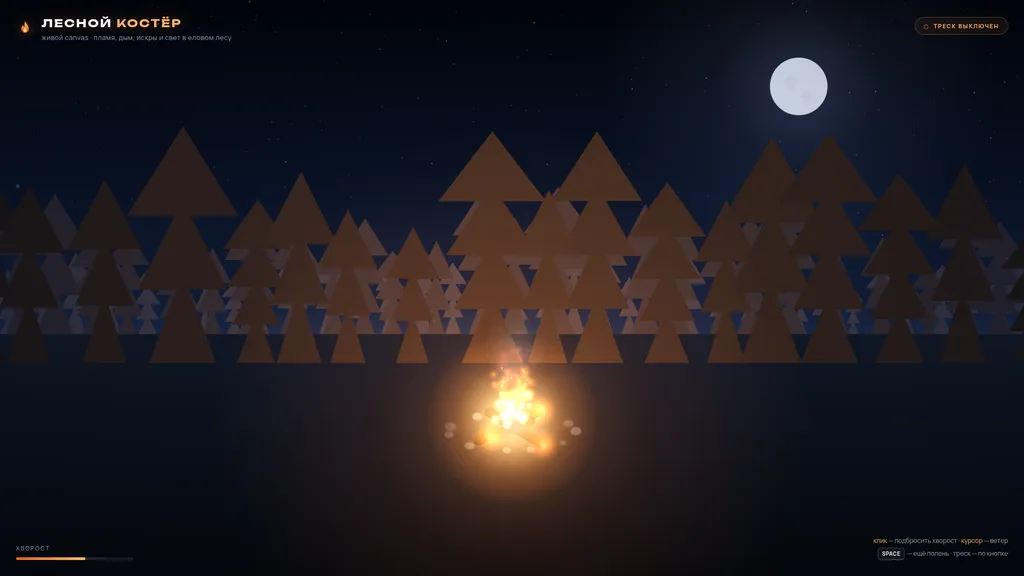
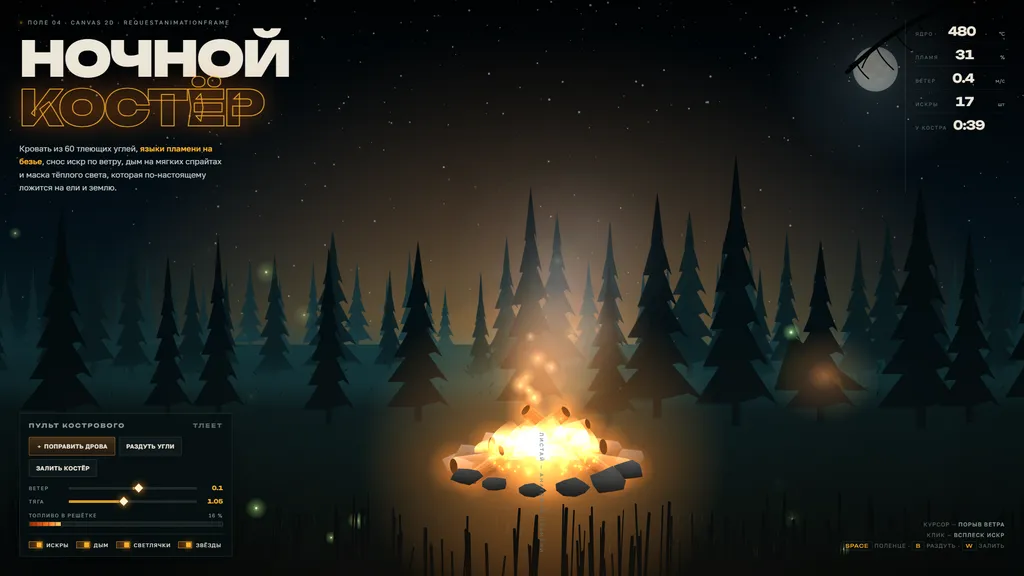
На самом деле это самый ужасный лес из всех тестов Qwen3.8-27B. Почему-то именно в FP8 он не удался. Но картинка точно самая лучшая у Qwen3.8-Flash-Next. Новичок точно не плох, но до Flash уровня не дотягивает.
2. Костер на берегу моря на фоне гор по сложному промту
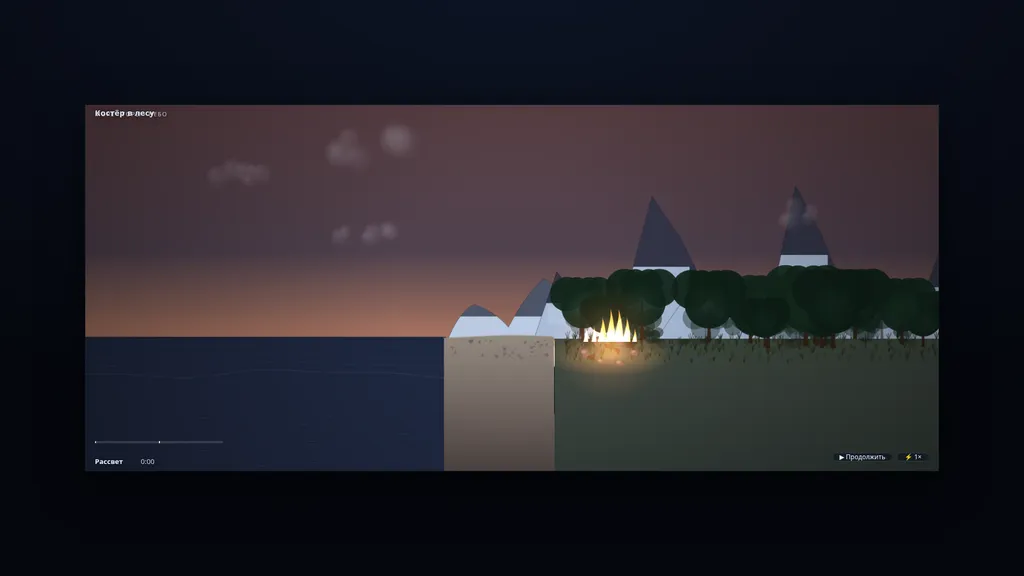
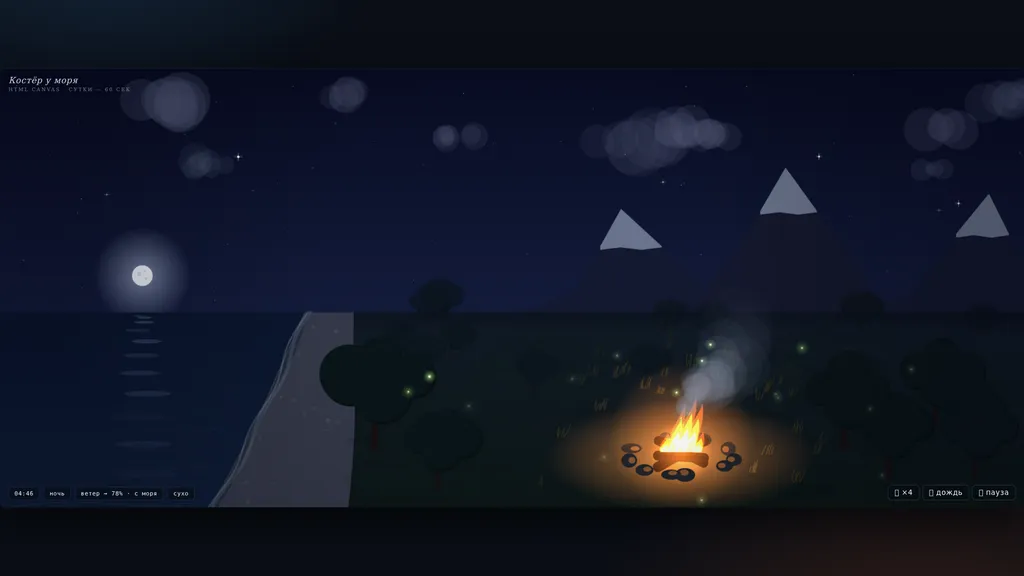
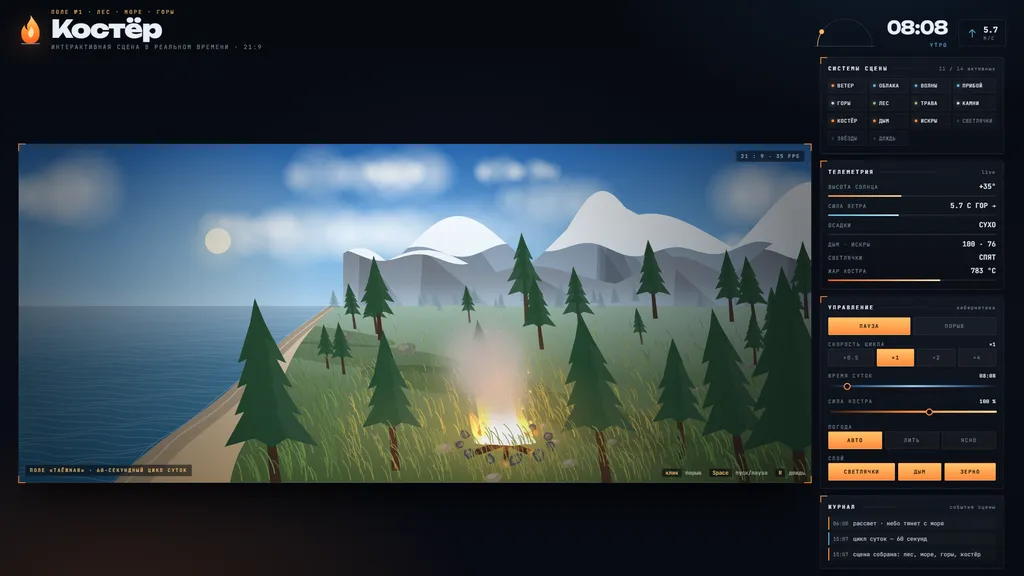
Пожалуй, Nanbeige тут выглядит получше, субъективно, чем 27B, но до Flash-Next далеко.
3. 3Д Тетрис
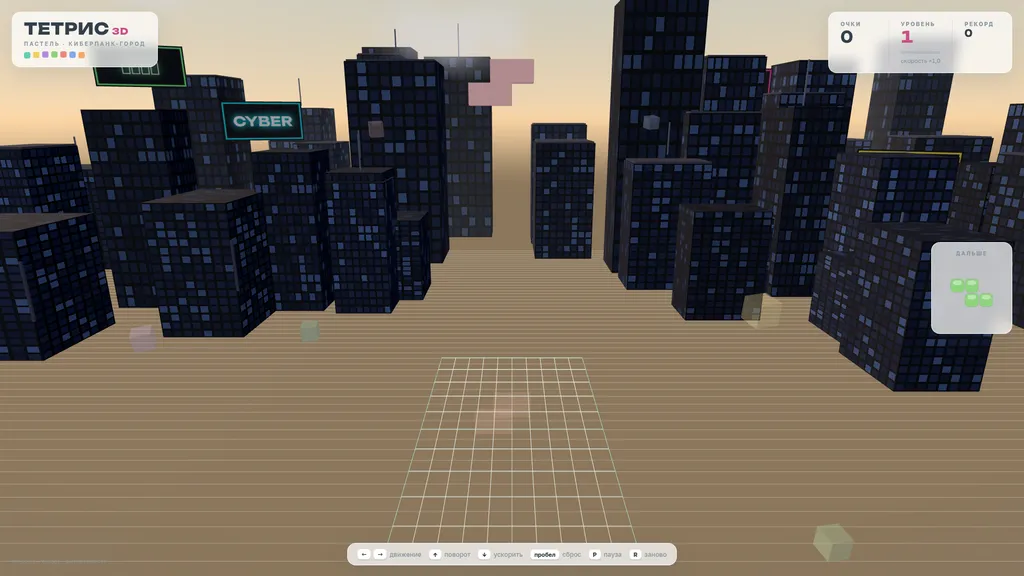
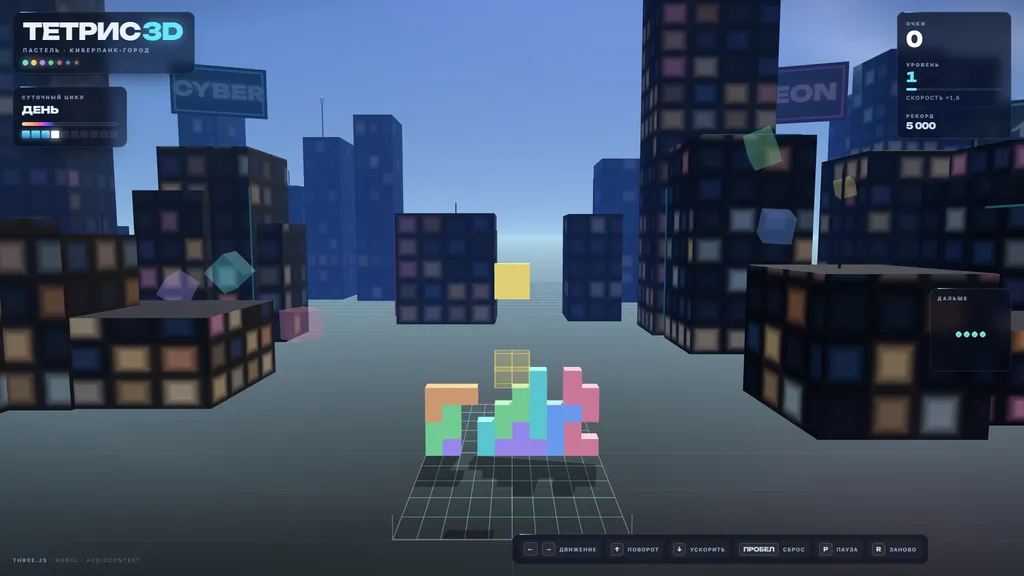
Обе модели Qwen выдали очень сходный и почти неразличимый результат.
Nanbeige же тут не справился вообще. В целом, с данным тестом кроме Qwen3.8 справляются только Gemma 4 31B и Deepseek V4.0 Flash из протестированного автором, да и то условно. Поэтому тут чуда не случилось.
Вывод по первым впечатлениям
Модель Nanbeige4.3-33B небезынтересна, явный конкурент Qwen3.8-27B. Но в ходе измерений оказалась куда медленнее, 20 ток/с против 34-40 без MTP у Qwen3.8-27B на той же паре Radeon R9700, что соотносится и с размером, и с отсутствием оптимизаций.
Прорыва в качестве сходу не видно. Возможно именно на задачах кодирования будет лучше, но с учетом скорости и отсутствия vision, в целом сложно найти мотивацию для перехода на нее с последнего dense Qwen.
В любом случае, конкуренция это хорошо. Ждем новинки и дальше.
