Публикуй без сомнений, без проверок, спокойно и круто.
Иногда я нахожу ошибки в образовательных книгах. Речь идет не про опечатки, а про неточности в формулах или примерах. Такое случается довольно редко. Бывают случаи, когда я думаю, что наткнулся на очередную ошибку, потом проверяя, понимаю, что неправ оказываюсь сам. Постоянно возникают сомнения, от которых невозможно избавиться.
Недавно, читая одну книгу про финансы, я заметил ошибку в тексте. Эта ошибка была элементарной. В книге приводился пример со сделками, которые совершают две стороны. Пример занимал один короткий абзац с простейшей формулой. По итогу та сторона, которая должна была заработать деньги — их теряла и наоборот. Просто в книге перепутали A и Б местами. Ничего катастрофического здесь нет, книга очень объемная, с кучей формул и примеров. Практически любой человек, который знаком с понятием «проценты», сразу же увидел бы ошибку.
Мне стало интересно, а справятся ли с такой задачей ЛЛМки?
Я сделал скрин и закинул его в chat GPT без какого-либо вопроса. Модель правильно выдала мне информацию, о чем идет речь. Потом я спросил, есть ли ошибка в примере. На что я получил какие-то стандартные замечания, которые обычно пишут модели. Но про главную принципиальную ошибку не было ничего. И только когда я указал, где находится ошибка, тогда я увидел:
«Сторона A действительно зарабатывает $125,000. Так что ты заметил реальную ошибку в тексте: на картинке направление платежа противоречит указанным cash flows.»
C Дипсиком вышло то же самое.
{Если кому сильно интересно, можете написать мне, я скину пример и чаты с моделями. Я уж не буду здесь все выкладывать.}
Меня удивляет то, что современные модели сегодня реально могут решать сложнейшие математические проблемы. Могут писать код с нечеловеческими скоростью и объемами. Они уже анимацию делают, даже не генеря видеоряд, а непосредственно оперируют внутри самого софта, типа AE. Музыку пишут прямо в DAW, типа Ableton. То есть готовый продукт уже невозможно будет технически отличить от того, что был сделан человеком, из-за отсутствия специфического следа нейросетей (речь про тот же SUNO).
И несмотря на всю их мощь, модели обречены на такие ошибки, сделанные на ровном месте.
И chat GPT, и Дипсик потом ожидаемо (это генеративные модели) предлагали мне то, что я еще мог бы узнать в контексте. ЛЛМки давали мне релевантные пути дальнейшего изучения вопроса, почти совпадающие с книгой, которую я читаю.
Но они не смогли найти простейшую ошибку там, где даже контекст не нужен был и токенов надо было жменю потратить. Объем задачи был совсем небольшой.
Хотя, не просто так пишут внизу страницы, что:

Допустим, здесь нет ничего опасного в том, что модель ошиблась. Но если предположить, что то же самое произойдет там, где цена ошибки будет выше. Уже становится не так спокойно.
Самое неприятное в том, что проверять будут в основном там, где сложно, а на очевидные моменты забьют. Это я с уверенностью говорю, как человек, который имеет некоторый опыт в исследованиях.
Давно, когда я еще трудился в лаборатории на рентгене, у меня бывало такое, что часами я сидел весь злой и непонимающий, почему нет отраженного сигнала на детекторе. Я вращал образец, как только можно, дергал все параметры, менял положение детектора (менял детекторы), задавал разное количество активных пикселей, двигал сам детектор туда-сюда. Проблема была в том, что я просто не вытащил из специального слота щель расходимости. Из-за этого у меня сильно резало интенсивность пучка. Этот тонкий лист металла с прорезью, вставляемый в одно из множеств мест на установке (в первичную оптику, например), нехило так блочил такие необходимые мне фотоны.
И это простая проблема, на которую не обращаешь внимание. А она мешает вообще всему.
Простое, очевидное, не стоящее внимания иногда крайне важно. Мне бы сильно не хотелось, чтобы ошибки такого рода, про которые я рассказал, выше просочились куда-то в атомную энергетику или медицинскую технику, или еще куда-нибудь.
Волнительно то, что моделям будут доверять беспрекословно и уж тем более в таких простых вопросах.
Великолепно то, что специалисты изобретают жесточайшие бенчмарки для проверок моделей. Есть специальные ресурсы, где собирается статистика и рейтинги по перформансу, стоимости и другим параметрам моделей со всего мира. Люди пытаются выдумать вопросы, на которые нейросеть не может ответить, а потом снимают (переснимают) рилсы, обличающие провалы роботов.
А можно не выдумывать, взять кусок душной книги, где есть ошибка и закинуть в ЛЛМ, чтобы она проверила. Фейл также возможен и ничего вычурного не потребуется.
Вот на этом фоне особенно хорошо выглядит рекламная рассылка от chat GPT, которую я недавно получил.
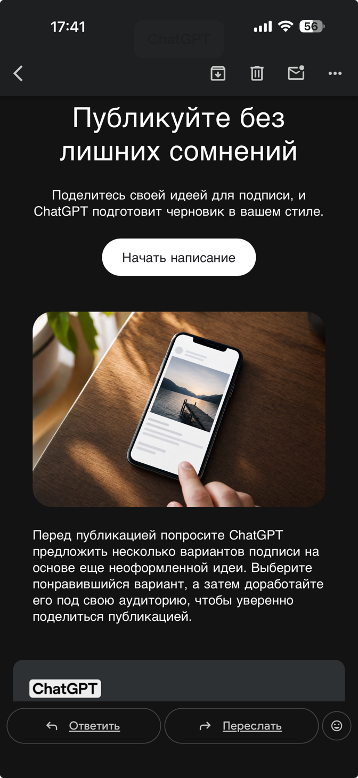
Публикуйте без лишних сомнений, но проверяйте важную информацию, так как модель может допускать ошибки. На мой вкус выходит немного противоречиво, но какая разница, мелкий шрифт снизу все равно никто не читает. Сама реклама бьет в самое сердечко автора.
«Уверенно поделиться публикацией»
Ох как же приятно себе воображать ту уверенность, с которой ты публикуешь свою работу. Без лишних сомнений, без изнуряющих проверок и метаний.
Публикуй без задней мысли.
Каждый раз, когда автор этого текста собирается что-то написать, возникает очень интересное чувство — чувство жгучей неуверенности в том, а надо ли вообще все это писать, а правильно ли то, что ты тут написал, а поймут ли тебя, а правильно ли поймут, а для кого, а почему, а точно знаешь? Список можно продолжить.
А здесь — модель напишет в твоем стиле, да еще и без сомнений. Покупаю такое сразу же.
Кто-то скажет:
«Да люди тоже ошибаются, а потом их ошибки еще долгое время тиражируют без намека на критику.»
Все так, но хотя бы остается пространство, в котором известно с кого можно спросить (если жив). Люди не идеальны и тоже ошибаются, возможно, даже еще сильнее, чем произвольная современная ЛЛМ. Просто люди не могут генерить такие объемы слопа, как это делают модели.
Что выходит?
Большинство людей будет просто копипастить выдачу моделей, не проверяя ни слова.
«Братан, просто сделай хорошо, пожалуйста»
Пишет усталый разработчик Опусу в конце рабочего дня, когда модель не может дать ему то, что он хочет. Кожаный мешок вымотан общением с роботом — это ужасный опыт (я пробовал, мне сильно не понравилось). Постоянно что-то не то получается, а лезть проверять самому — выглядит настолько неподъемной задачей, что даже сама мысль о ней прогоняется прочь. Лучше пожечь токены и не сомневаться.
Уж точно не мне говорить о том, как надо делать правильно, как работать правильно, и что можно использовать, а что нельзя. Выбирать придется индивидуально. Сейчас многие пути взаимодействия с реальностью будут меняться и довольно серьезно. Количество ИИ в повседневной жизни любого человека на планете будет только расти и этому будет способствовать целый ансамбль различных факторов.
Скорее всего будет расти давление со стороны государства и компаний, где вы работаете. Эти институты будут активно подталкивать людей к использованию ИИ. Огромная часть бюрократии уже переведена в такой режим. Общество будет шеймить и обзывать луддитами тех, кто будет стараться не прибегать к помощи ЛЛМок.
Есть ненулевая вероятность, что будут предприняты попытки все окончательно зарегулировать и оптимизировать с помощью ИИ. Есть также вероятность, что много, где не получится.
И это немного обнадеживает.
Не уверен, могу ли я говорить о том, что действительно необходимо творческому человеку.
Я думаю, что всё-таки сомнение и некоторые творческие метания — необходимы.
Опять же вопрос в том, насколько себя необходимо накрутить, чтобы это было полезно, а не скатилось в откровенный вред.
Надо будет спросить у chat GPT, как найти правильный баланс.