Минутка проверки гипотез
Пока писалась большая статья, получилось побочное исследование скорости работы Unsloth/NVFP4 моделей, относительно таких же квантов Nvidia.
Изначально поводом для проверки стала страница unsloth/Qwen3.6-27B-NVFP4, на которой заявлялось, что NVFP4 квант Unsloth в 2,5 раза быстрее NVFP4 кванта Nvidia на том же железе.
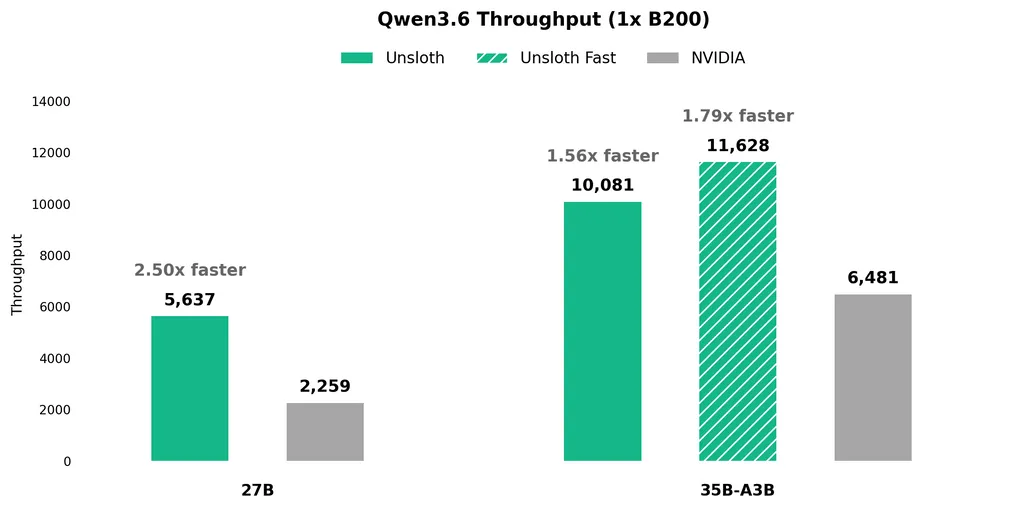
Аналогичные заявления были у Unsloth и в заметке про Qwen3.8-27B, ссылаясь на анлогию с 3.6.
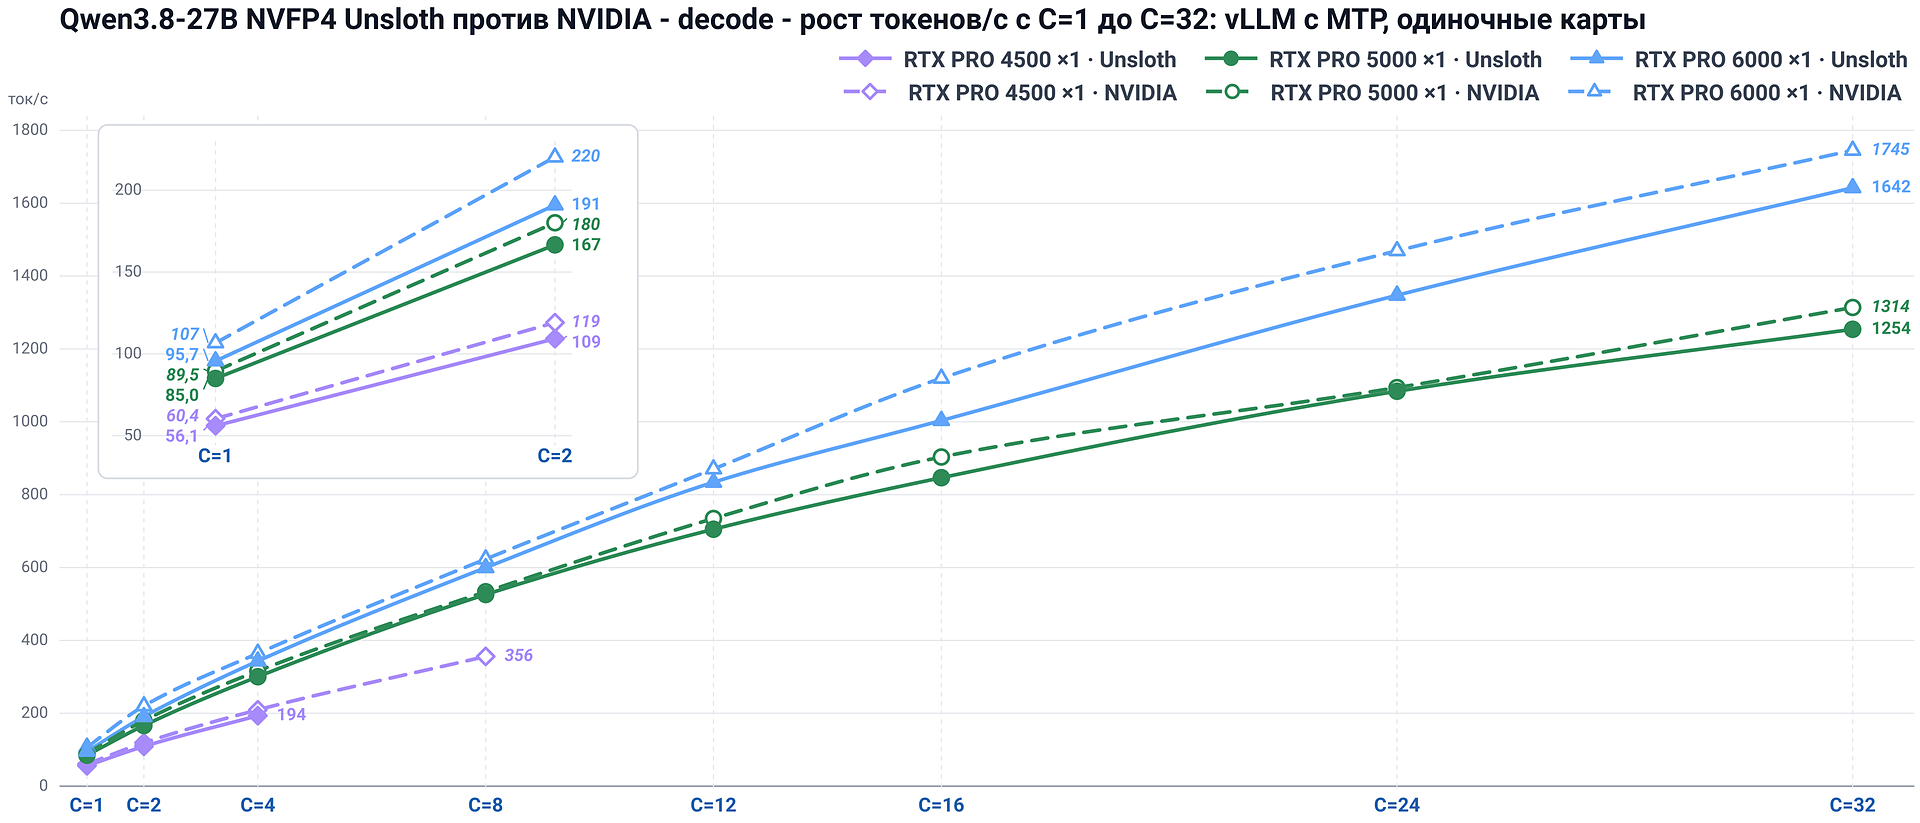
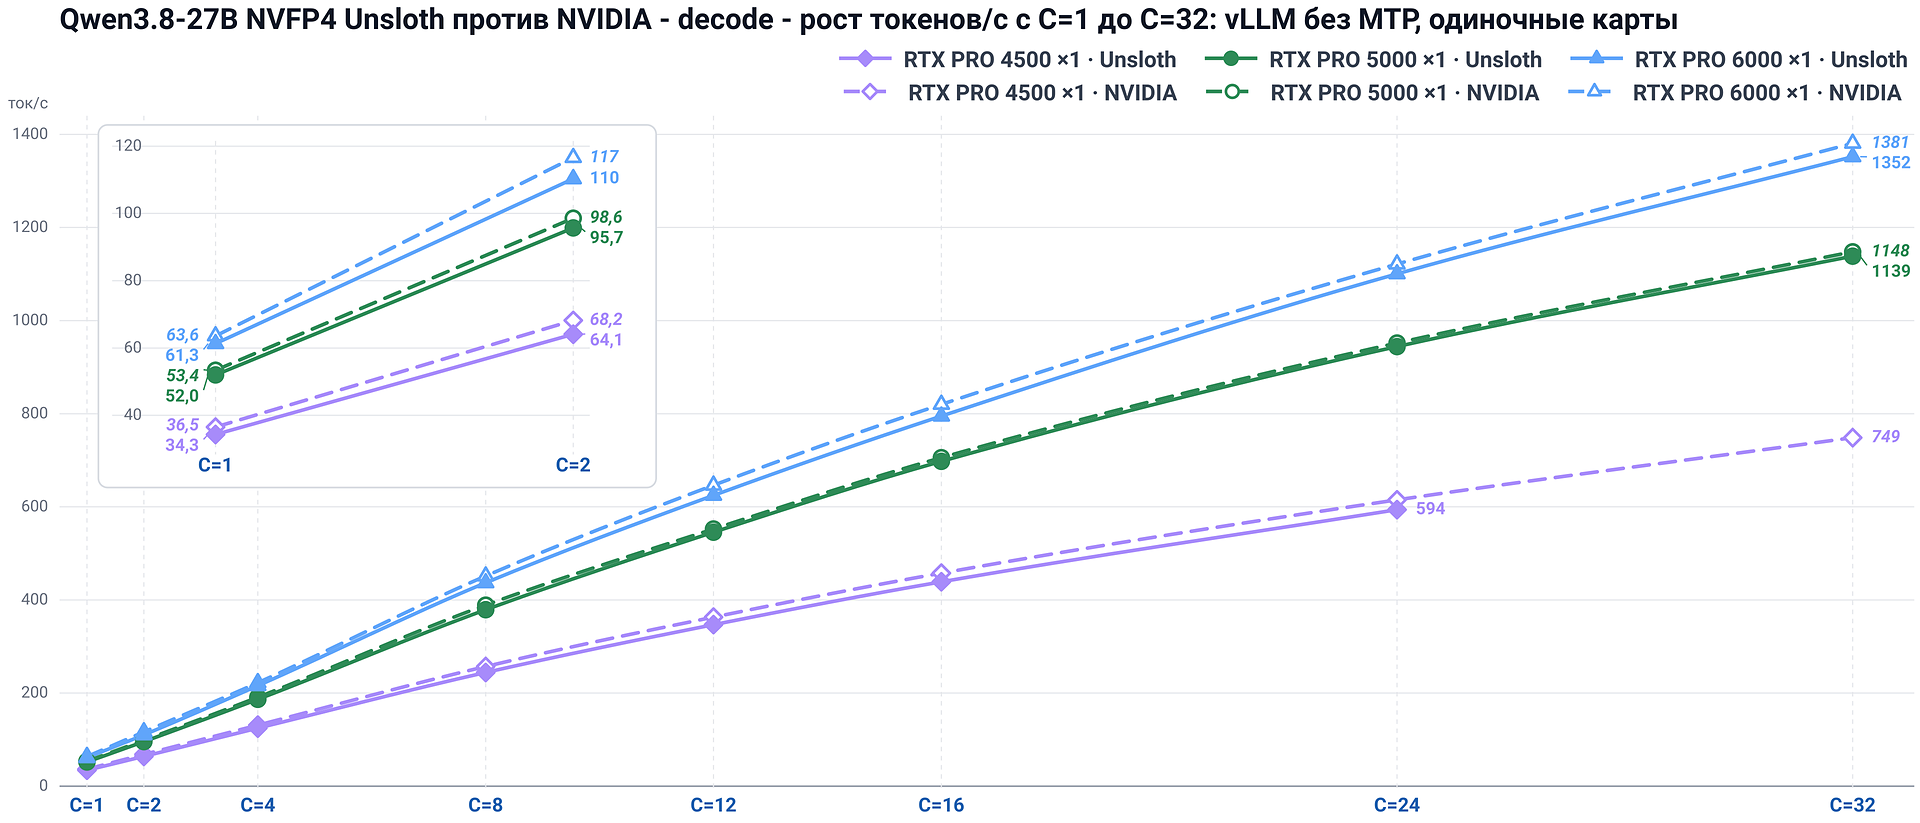
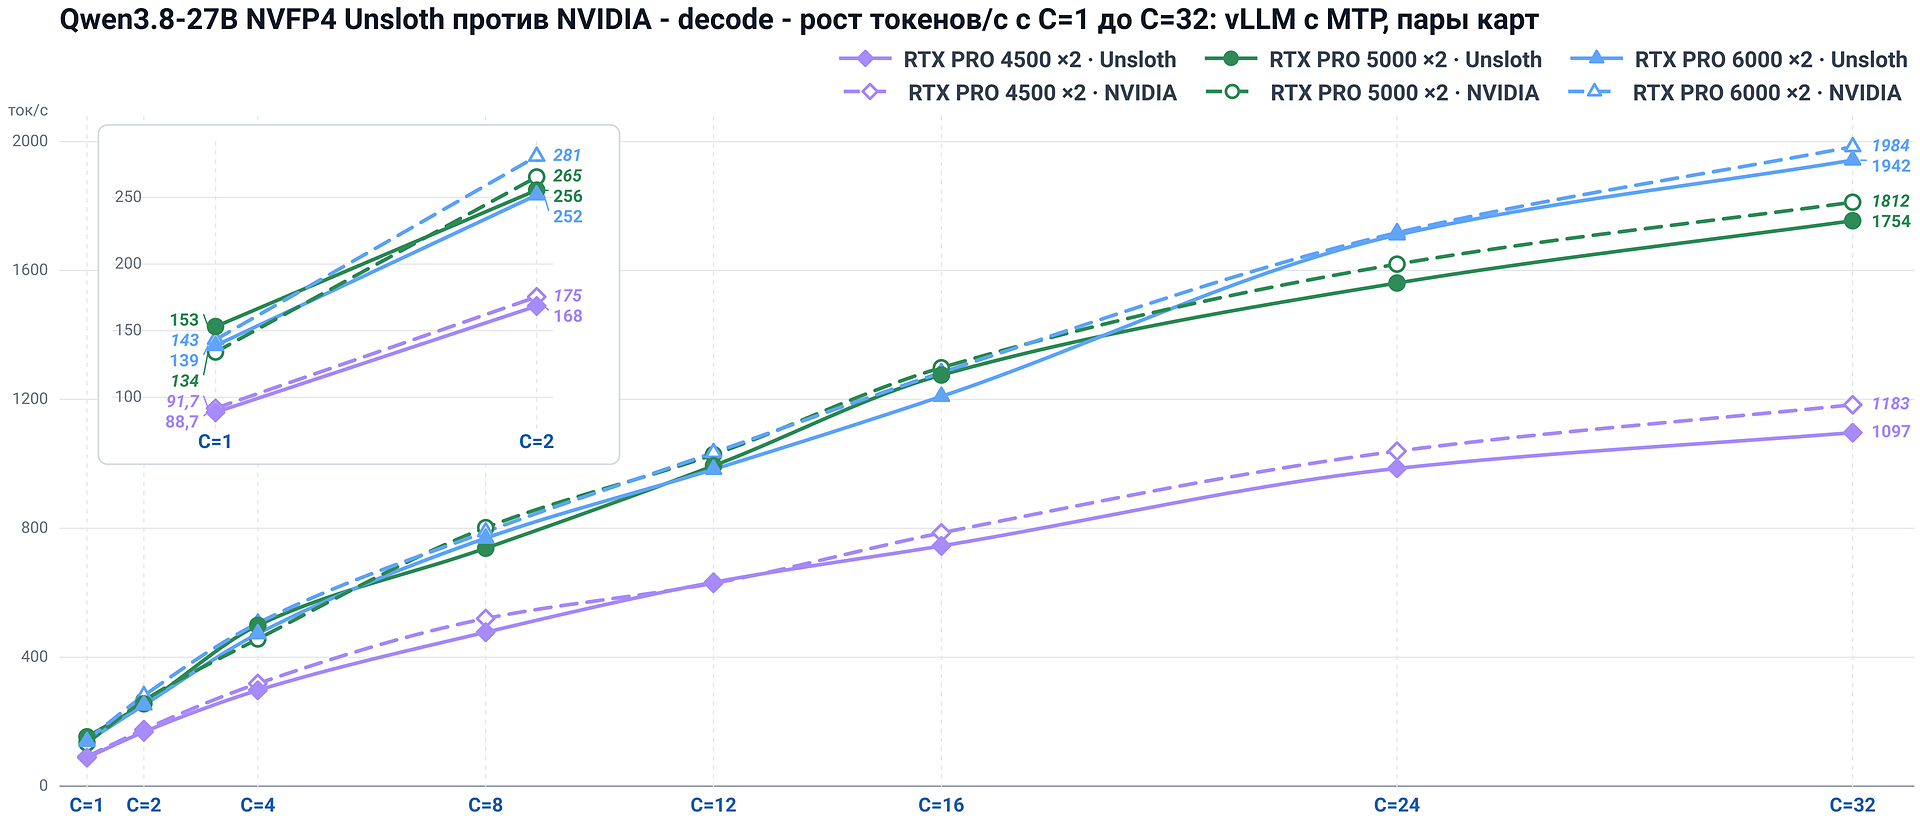
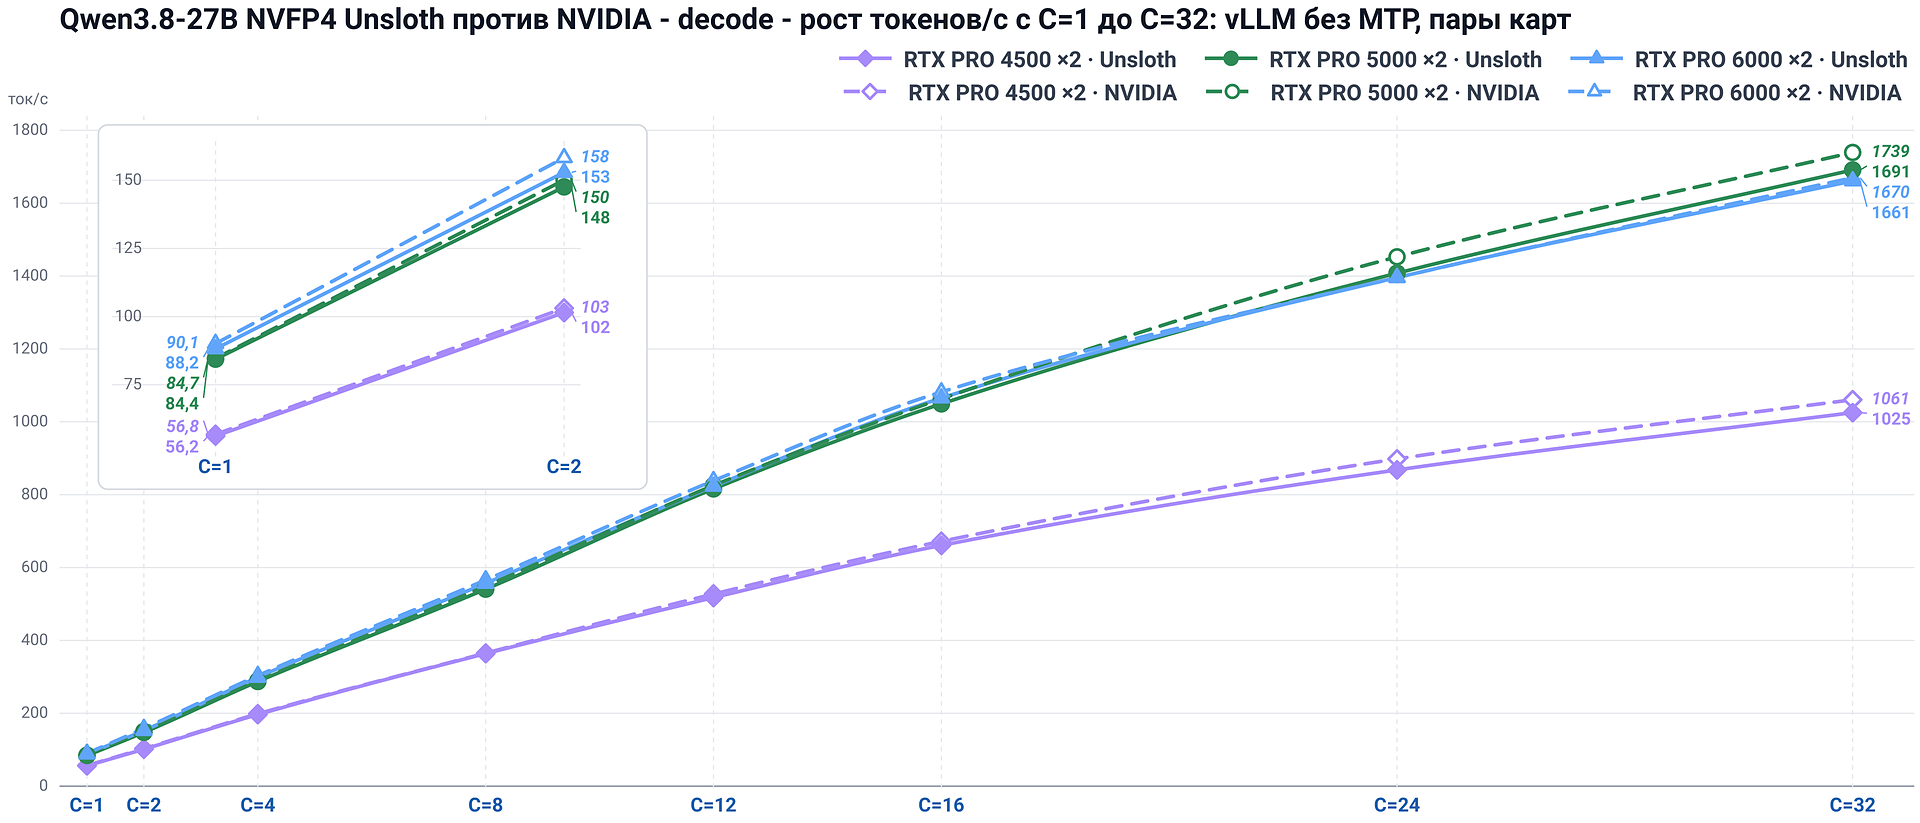
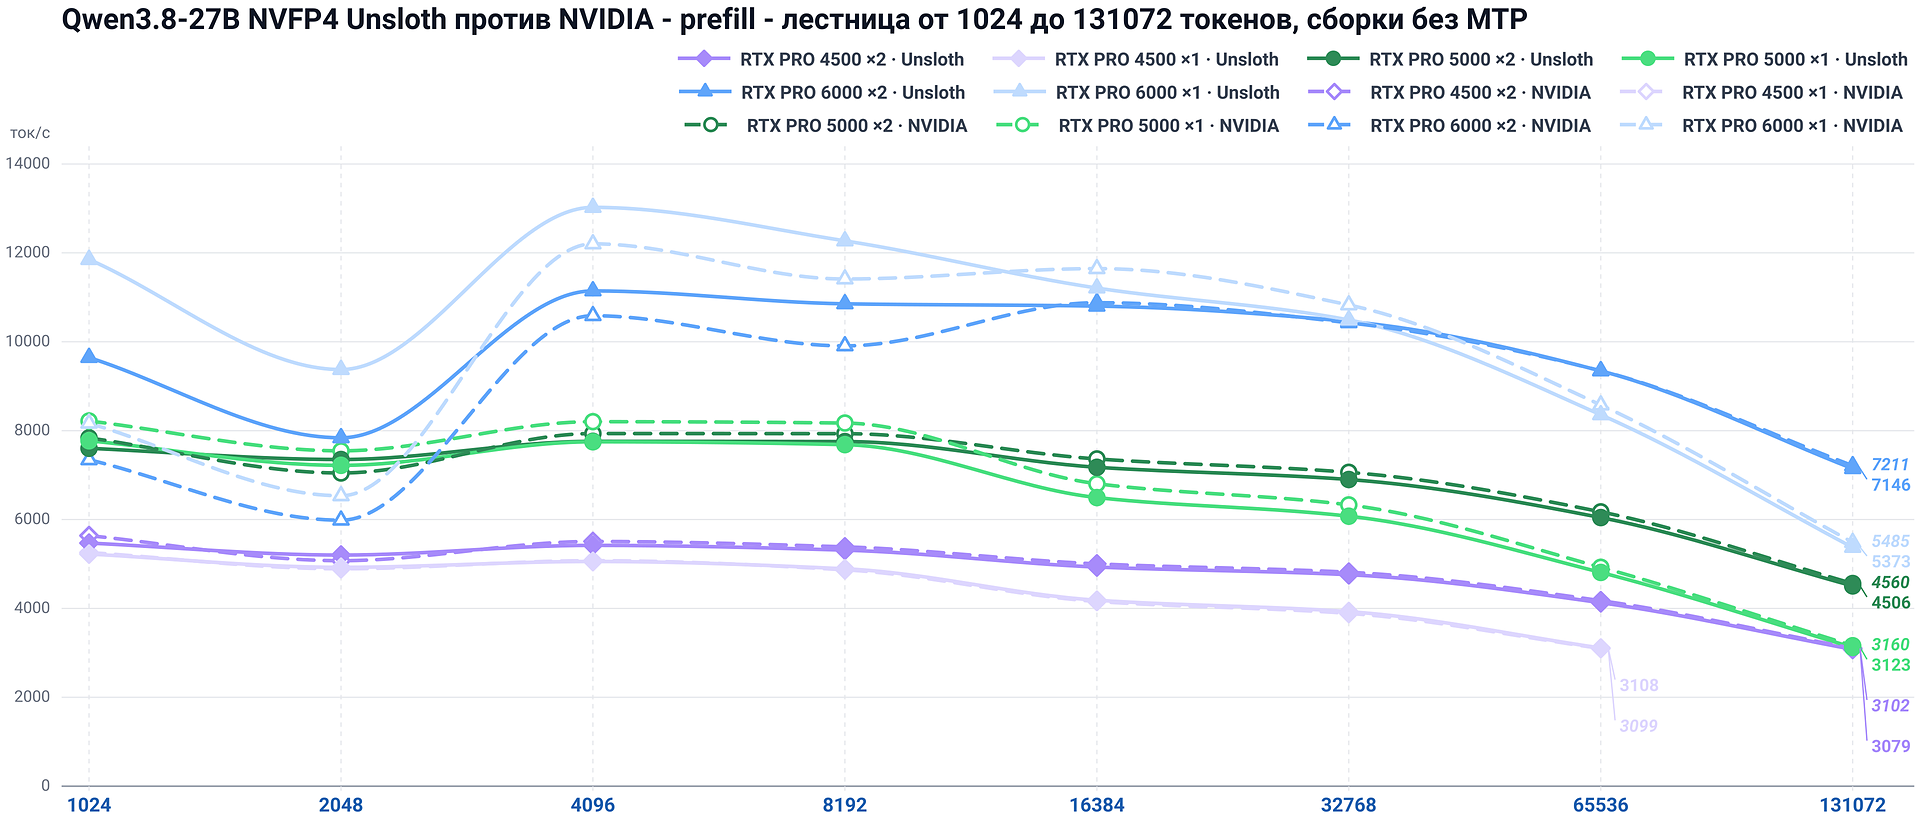
Т.к. именно на 3.8-27B готовились материалы к статье про Radeon, параллельно были проверены и кванты Unsloth против Nvidia. И как видно по первым 5 картинкам — разницы нет ни на одном из GPU Nvidia, на которых делались тесты:
Ок. Прогоним тест на Qwen3.6-27B вместо 3.8. Не могут же люди нас просто обманывать. Вторые пять картинок это как раз прогон на RTX PRO 5000:
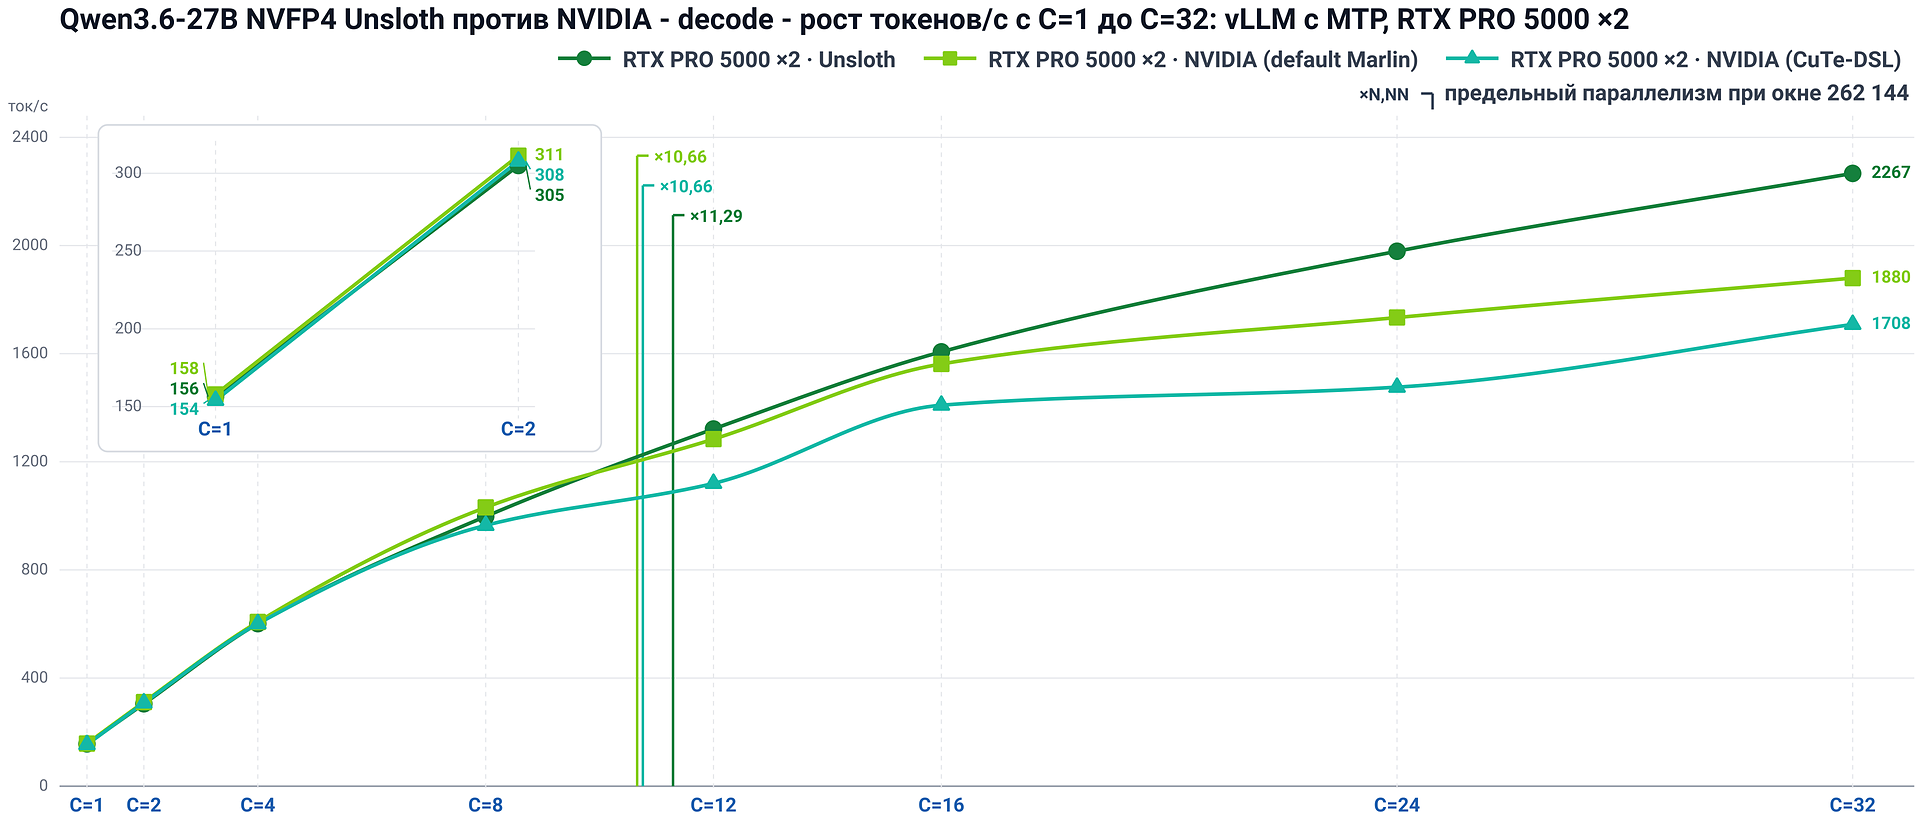
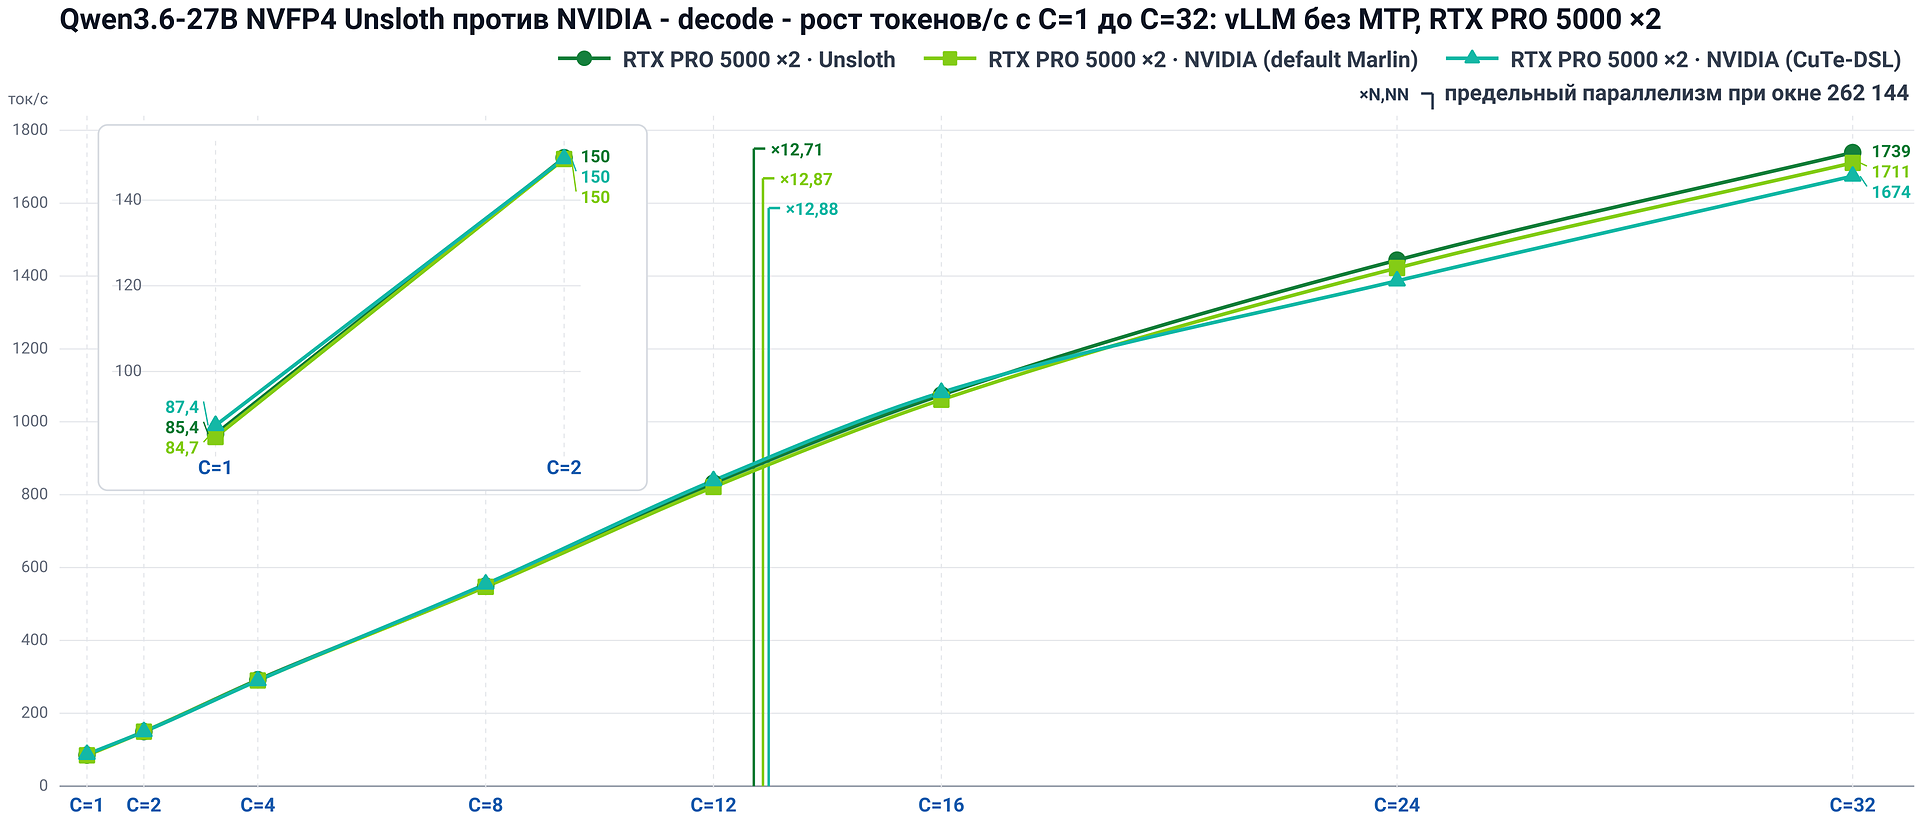
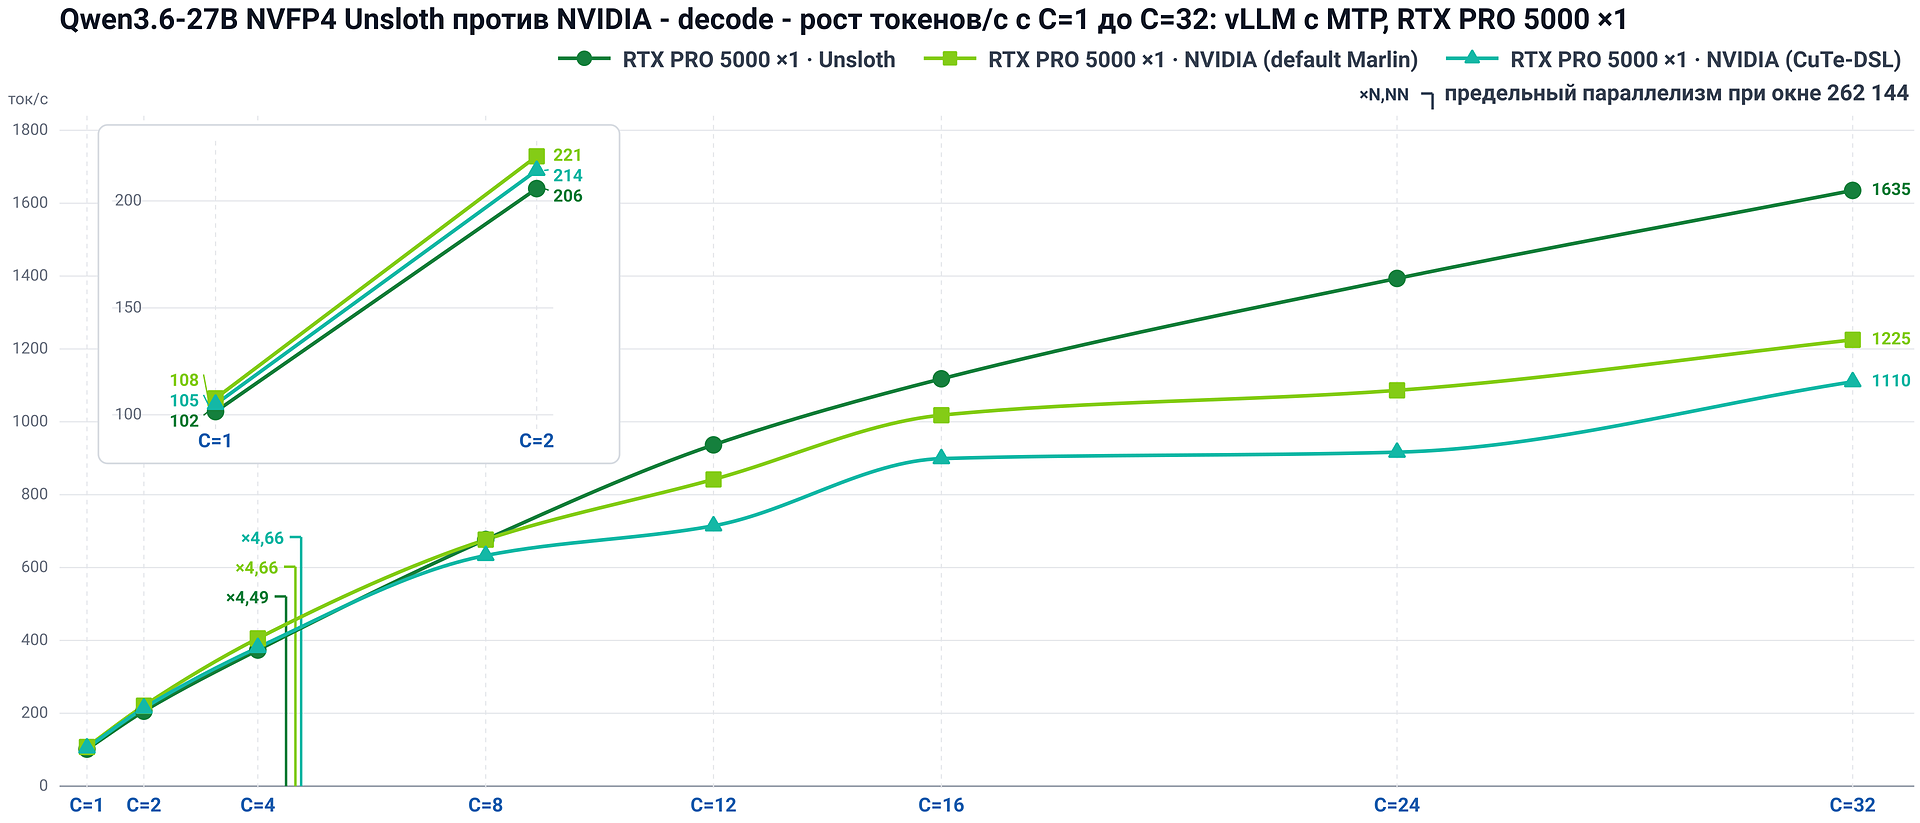
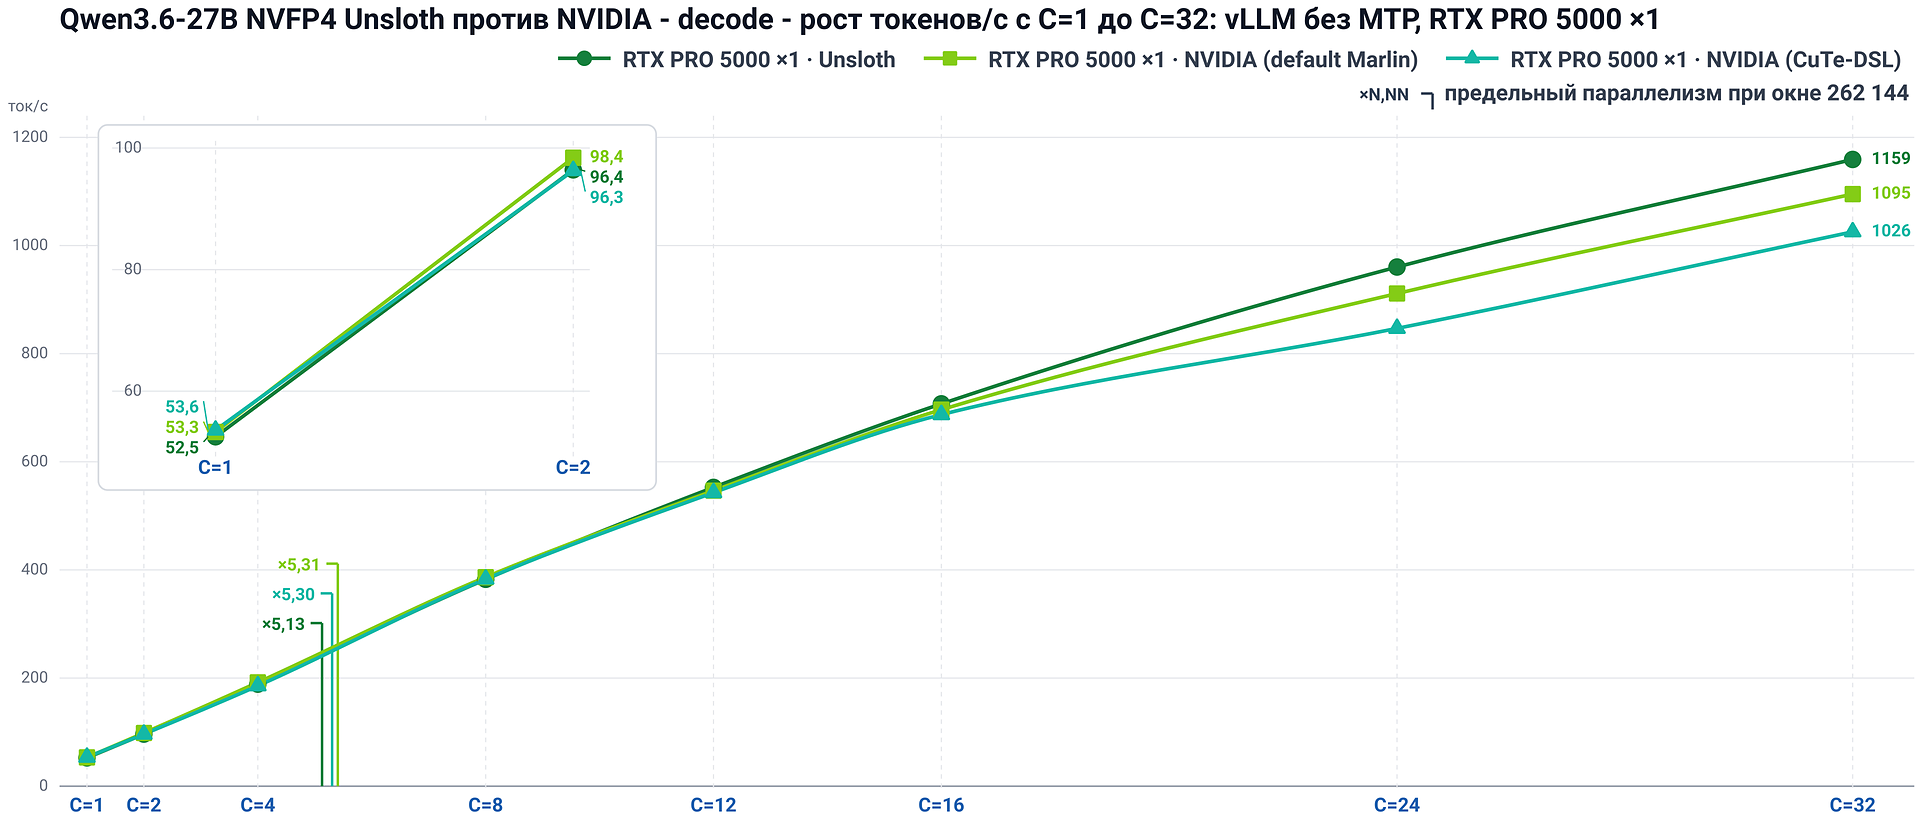
И результат тут оказался очень интересный. В decode разницы тоже толком не оказалось. Тут Unsloth явно наврали про throughput x1.5. А вот в prefill разница оказалась огромная в пользу Unsloth:
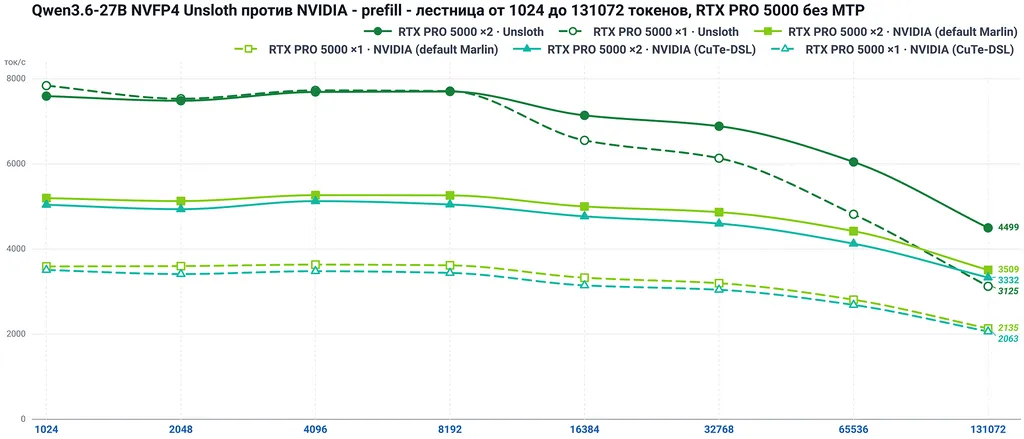
Ради интереса, сделан еще прогон на Nvidia c CuTe-DSL оптимизированно реализацией математики, против Marlin по-умолчанию, что улучшения результата не дало.
Т.е. разница есть, но вообще не там, где ожидалось. Провел краткое расследование с помощью ИИ:
Квантизация — это не только то, в чём веса лежат в памяти, но и то, в каком формате они поступают на вычисление. Tensor cores в Blackwell быстро умножают только пары одинаковой разрядности, и лестница пиковой скорости такова: BF16 — база, FP8 — вдвое быстрее, FP4 — ещё вдвое, то есть вчетверо против BF16. Буква «A» в названии схемы (W4A16, W4A4) говорит о втором множителе — активациях, то есть промежуточных значениях самого запроса: именно их разрядность решает, по какому из этих трактов пойдёт умножение.
Unsloth публикует чекпоинт (версия модели) как W4A4: движок перед каждым GEMM (сокращение от General Matrix Multiply, «общее умножение матриц»: операция вида C = A × B (+ C), в которой две большие матрицы перемножаются за один проход) динамически квантует активации до FP4, и умножение проходит по быстрому тракту целиком в FP4. NVIDIA публикует как W4A16: активации не трогаются, остаются BF16, поэтому веса распаковываются до BF16 и весь GEMM едет по базовому тракту. Четырёхкратная разница — это потолок самих умножений; в замере prefill выходит примерно двукратная, потому что неизменяемая часть конвейера — attention и проекции GDN в FP8 у обоих квантов, стоят одинаково, а динамическая квантизация активаций тоже не бесплатна. На decode разницы нет вовсе: узкое место — чтение одинаковых 4-битных весов из памяти. Всё это свойства чекпоинта, а не движка, и переключением Marlin/CuTe-DSL на запуске не лечится.
Т.е. в 3.6 имела место неоптимальная упаковка кванта Nvidia для исполнения на собственном железе, а в 3.8 ошибку банально исправили.
Маркетинг же про рост пропускной способности на реальных пределах параллелизма вычислений в vLLM оказался не корректным. Упор идет явно куда угодно, но не в разрядность активаций.
Как итог — не все кванты одинакого полезны. Надо смотреть не только формат упаковки, но и активации. W4A16 (Упаковка — 4 бита, активация 16 бит) куда медленнее W4A4 или W4A8 для FP8 вычислителей. И именно здесь лежит огромная часть реального ускорения инференса от корректного сочетания модели и железа.
