Минутка скорости за не дорого
Выходные после DotNext ушли на копание с железом.
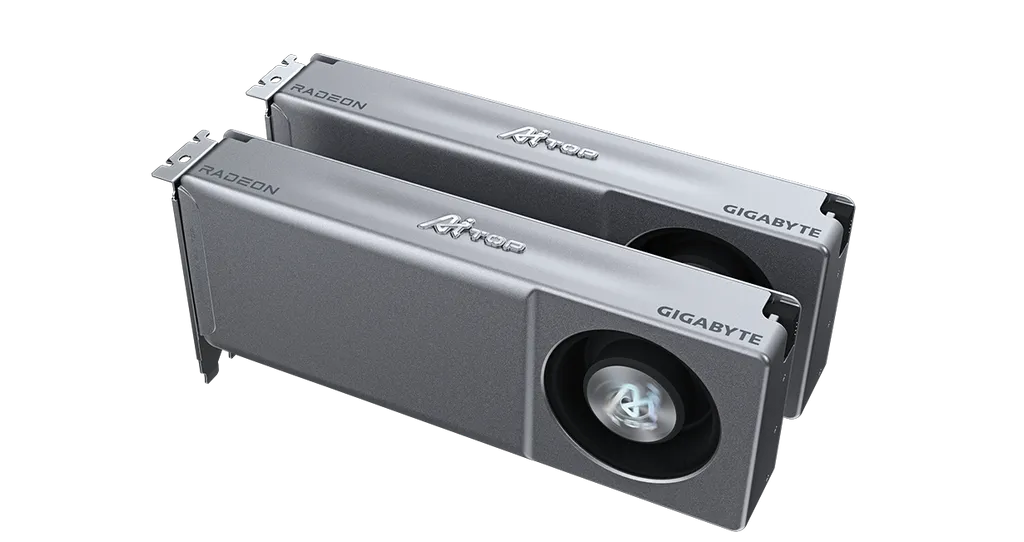
У соседей подсмотрел ссылку на проект vLLM Radiance — fork с патчами и специальным тюнингом под RDNA4, т. е. Radeon AI PRO R9700.
Так вот, на позавчерашнем докладе я приводил результаты измерения в vLLM и Qwen3.8-27B-FP8 для этих карт. И получалось что-то около 48-52 токенов в секунду генерации. Для сравнения, RTX PRO 5000 выдает 56 токенов в секунду, а их пара — 89.
На Radiance результат выглядит как средние 85 токенов в секунду на контексте в 200к на паре Radeon. Prefill — 3-4k токенов в секунду.
Т.е. скорость фактически выровнялась с RTX PRO с куда более быстрой памятью и чипом.
С такими результатами пара Radeon точно лучшее по экономике предложение на рынке с огромным отрывом (в моменте есть предложения по цене начала лета, что удивительно).
Для одной карты заявлена поддержка MXFP4 и квантов AMD Quark с исполнением на FP8 вычислителях. Будет испробована позднее. Должно быть еще быстрее за счет экономии памяти, но, увы, все равно NVFP4 не догнать по скорости, т. к. нет аппаратного ускорения распаковки. Так же точность будет чуть ниже аппаратного решения NVidia, но по имеющимся прикидкам потери не фатальны.
Надо теперь разбираться с картами NVidia. Явно из них можно выжать куда больше.
Мои параметры запуска под Ubuntu 26.04:
# tmux-сессия `docker`; контейнер создаётся один раз, дальше — podman start -ai radiance-27b-k3.
# Каталога tuned-конфигов монтировать не нужно: radiance несёт свои fp8-configs в образе и
# использует собственный preshuffle-диспетчер block-FP8 GEMM (строк «Using configuration from» нет).
mkdir -p ~/vllm-radiance/cache

#keeperovod - имя пользователя, из под которого идет запуск

podman run -it --name radiance-27b-k3 \
  --device /dev/kfd --device /dev/dri --group-add keep-groups \
  --security-opt seccomp=unconfined --ipc=host \
  --cap-add SYS_PTRACE --cap-add SYS_NICE -p 8000:8000 \
  -e HSA_XNACK=0 -e PYTORCH_ALLOC_CONF= -e GPU_MAX_HW_QUEUES=1 \
  -e HSA_TOOLS_DISABLE_REGISTER=1 \
  -e HIP_VISIBLE_DEVICES=0,1 -e ROCR_VISIBLE_DEVICES=0,1 \
  -e NCCL_PROTO=Simple -e NCCL_P2P_DISABLE=1 -e NCCL_TIMEOUT=1800 \
  -e TORCH_NCCL_ENABLE_MONITORING=0 -e TORCH_NCCL_HEARTBEAT_TIMEOUT_SEC=1800 \
  -e VLLM_ROCM_USE_AITER=1 -e VLLM_ROCM_USE_AITER_UNIFIED_ATTENTION=1 \
  -e VLLM_ROCM_USE_AITER_MHA=0 -e VLLM_ROCM_USE_AITER_MLA=0 -e VLLM_ROCM_USE_AITER_MOE=0 \
  -e VLLM_ROCM_USE_AITER_LINEAR=0 -e VLLM_ROCM_USE_AITER_FP8BMM=0 \
  -e VLLM_ROCM_USE_AITER_FP4BMM=0 -e VLLM_ROCM_USE_AITER_RMSNORM=0 \
  -e HIP_FORCE_DEV_KERNARG=0 -e TORCH_BLAS_PREFER_HIPBLASLT=0 \
  -e TORCHINDUCTOR_COMPILE_THREADS=4 \
  -e VLLM_CACHE_ROOT=/cache/vllm -e TORCHINDUCTOR_CACHE_DIR=/cache/inductor \
  -e TRITON_CACHE_DIR=/cache/triton -e AITER_ROOT_DIR=/cache/aiter \
  -e TRITON_CACHE_AUTOTUNING=1 -e HF_HUB_OFFLINE=1 \
  -e RADIANCE_WEIGHT_QUANTIZATION=fp8 -e RADIANCE_AR_MAX_KB=81920 \
  -e RADIANCE_FAST_DRAFT=1 -e RADIANCE_DRAFT_RERANK=64 -e RADIANCE_VERIFY_HEAD=1 \
  -e 'RADIANCE_SPECULATIVE_CONFIG={"method":"mtp","num_speculative_tokens":3,"attention_backend":"R4D","disable_padded_drafter_batch":true}' \
  -v /home/keeperovod/models:/opt/models:ro \
  -v /home/keeperovod/vllm-radiance/cache:/cache \
  docker.io/magiccodingman/vllm-radiance:1.0.387 \
  /opt/models/Qwen/Qwen3.8-27B-FP8 --served-model-name Qwen/Qwen3.8-27B-FP8 \
  --tensor-parallel-size 2 --max-model-len 262144 --gpu-memory-utilization 0.97 \
  --max-num-seqs 32 --max-num-batched-tokens 8192 \
  --kv-cache-memory-bytes 13150240768 --kv-cache-dtype fp8 \
  --attention-backend R4D --enable-prefix-caching --mamba-cache-mode align \
  --enable-chunked-prefill --disable-custom-all-reduce --no-async-scheduling \
  --enable-auto-tool-choice --tool-call-parser qwen3_coder --reasoning-parser qwen3 \
  --host 0.0.0.0 --port 8000
Для 4-8 потоков скорость составит по бенчмарку 210-330 токенов. Пик из протестированного около 730 токенов в секунду генерации для 32 потоков. KV-кэш в FP8 при этом 691 240 токенов, т. е. 2,63 полный 262К контекста, что на практике позволяет использовать 3-4 потока до offload с учетом фактического заполнения при 50+ токенах на поток.
Это просто отличный результат, который всегда хотелось получить. Владельцам можно праздновать.
