Минутка инженерных открытий в multi-GPU
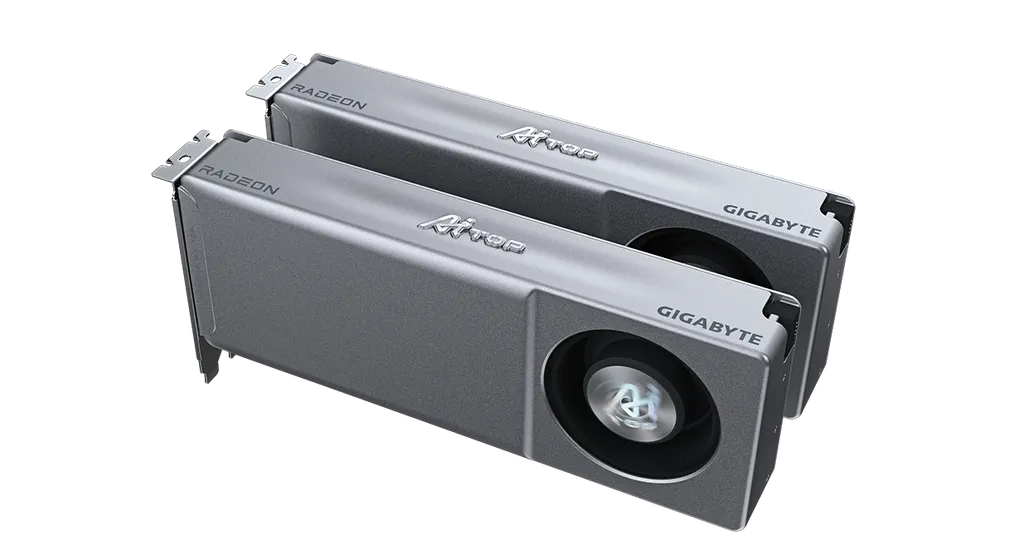
В ходе раскопок нашлась реальная супер-магия.
Вот в жизни бы без экспериментов не выяснил. Не зря лабораторию собирал.
В общем, при работе карт в парах или четверках есть необходимость синхронизации памяти (кэши и т. п.).
И тут есть два варианта — P2P через PCI-E, т. е. карты напрямую пишут друг-другу в память. Ограничение только скорость самой шины. Требуется поддержка на уровне драйверов и железа.
А есть SHM (staging host RAM) — обмен через оперативную память хоста. Он работает на всем, что угодно, но упирается в скорость хостовой памяти. Вроде как не критично, но потери есть и зависят от CPU/RAM.
Так вот, P2P нет ни у Radeon RDNA (9070XT, R9700), ни у потребительских RTX карт. А вот у RTX PRO оно включено на уровне драйвера. Вроде как у RTX тоже включать научились программным путем, но стабильность вопрос очень отдельный. Т.е. аналогичные GPU RTX будут всегда медленнее полностью аналогичных RTX PRO, если работают больше одной штуки.
На практике это выглядит как постоянно загруженный CPU на машине без P2P и загруженная память на чтение-запись при инференсе. Долго понять не мог в чем разница, т. к. на машине с RTX PRO CPU полностью простаивает вне вычислений (хотя под нагрузкой vLLM его грузит), а на машине с Radeon же CPU загружен независимо от наличия нагрузки.
И вот тут появляется прямой смысл брать Threadripper/Xeon, т. к. 8 каналов памяти автоматом развязывают это бутылочное горлышко в виде скорости системной памяти для не RTX PRO GPU, заодно давая полный по ширине PCI-E.
