Минутка сравнения Geforce с Radeon. И опять с облаками
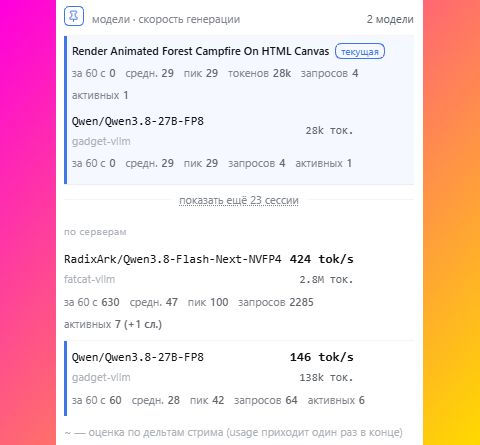
Запустил тут более менее интересную нагрузку на оба ПК с GPU имеющихся в домашней лаборатории — 2x RTX PRO 5000 Blackwell 72ГБ и 2x Radeon AI Pro R9700 32ГБ.
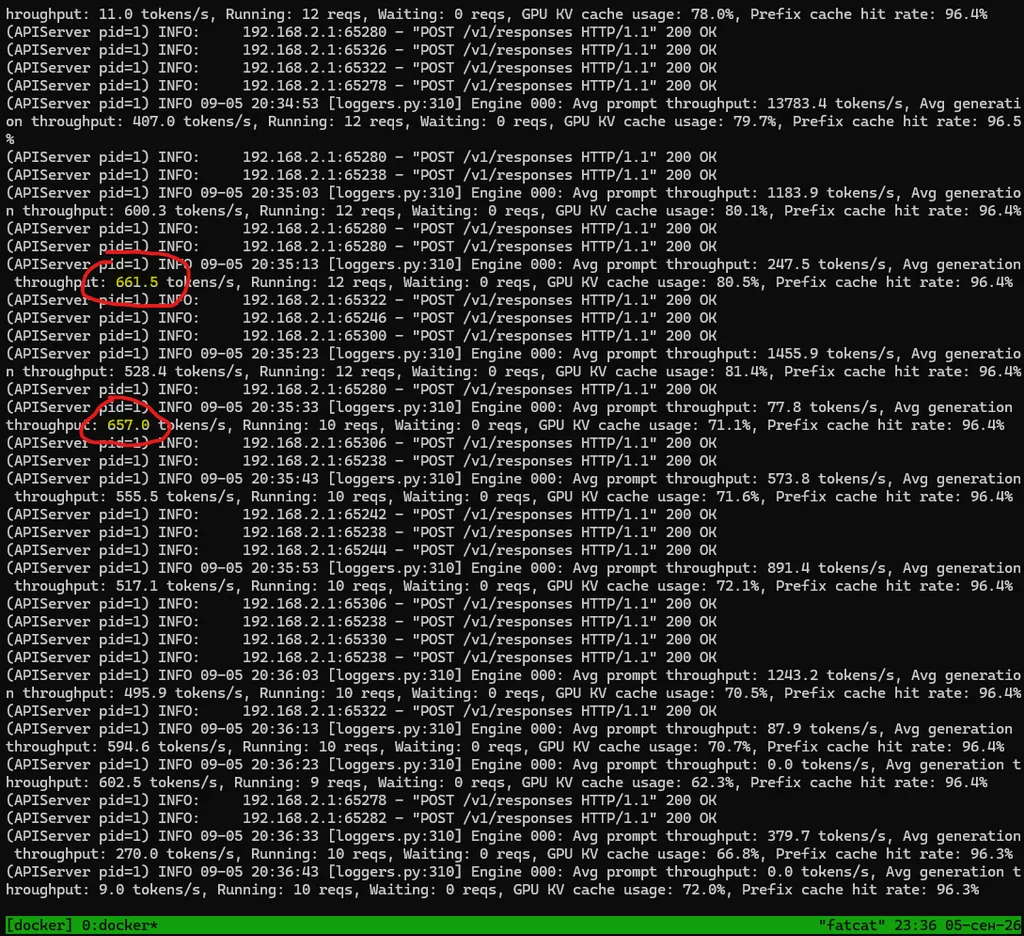
Пара RTX PRO выдает 650-660 генерации токенов в секунду на 10-12 потоков параллельно при где-то 1,6-2 миллионах активного контекста (80-99% от примерно 2 миллионов, на которых хватает памяти) на Qwen3.8-Flash-Next-NVFP4. Бенчмарк говорил про 557 на 8 параллельных потоках, но это не предел с точки зрения мощности вычислительных блоков карт, как видно по картинке. Имеем 50-60 токенов на поток при максимально возможной загрузке, что очень не плохо. У облачного Opus — 61 токен в секунду, как писал в прошлой заметке. И это всё без MTP, который пока для свежей модели еще не работает, хотя тут возможен и регресс общей производительности. Этого за глаза не только для агентских нагрузок, но и для чата.
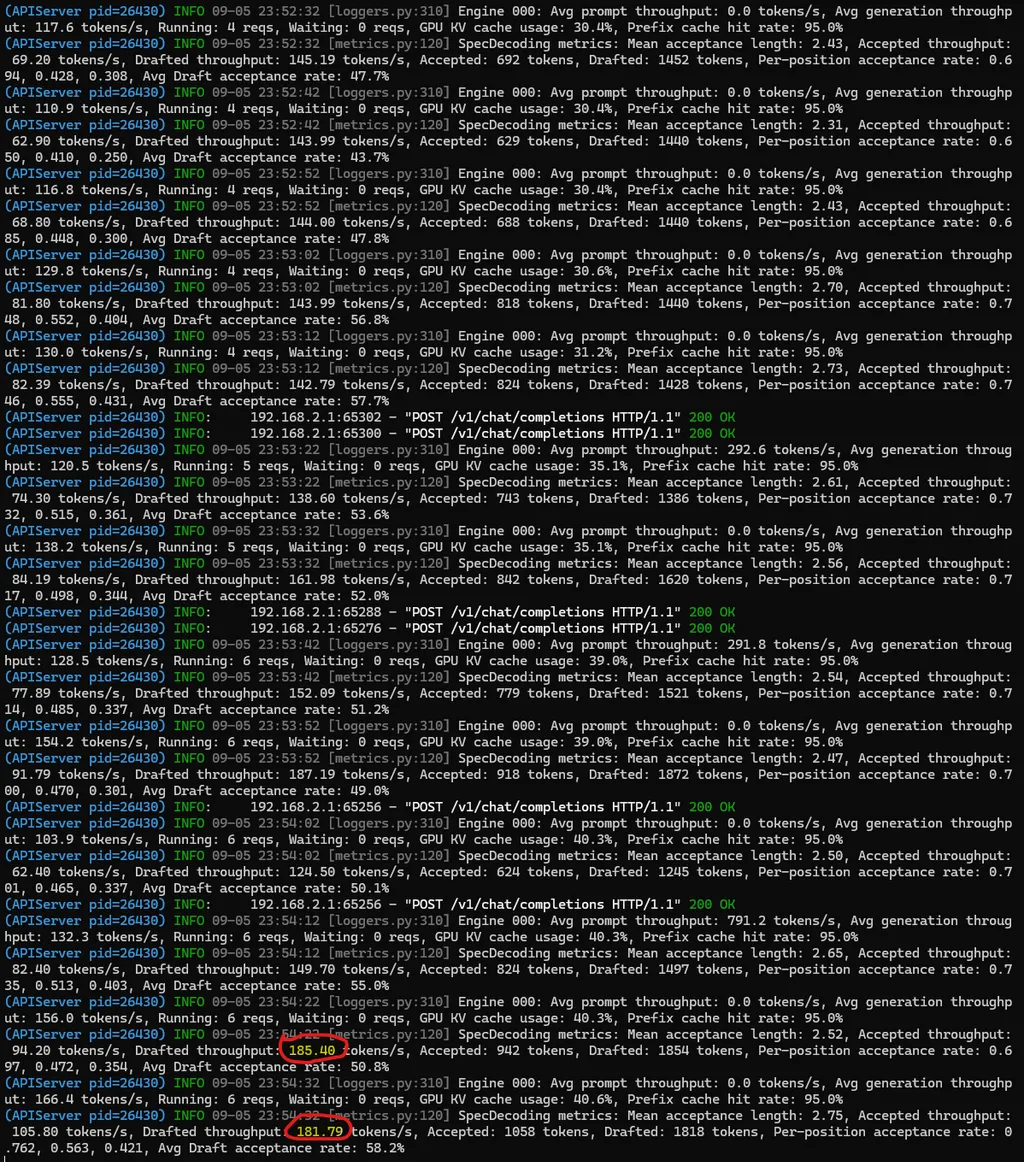
Два Radeon выдают около 30-40 в один поток при 200к контекста на Qwen3.8-27B-FP8 и 50+ на пустом. На 6-ти параллельных потоках картинка уже куда интереснее — до 140-180 токенов в секунду в зависимости от степени забивания памяти. У 27B модели нет чудесных n-gram весов, которые держат производительность ровной независимо от объема контекста. Это дикий скачок от llama.cpp, которая больше 50 с хвостиком не выдавала с пустым контекстом, опускаясь до 30 по мере наполнения и умирая на втором потоке. Т.е. 25-30 токенов на поток при 6 параллельных, чего для агентских сценариев в целом достаточно, хотя хотелось бы и побольше.
И для одного сетапа, и для другого это лучшее, что сейчас можно запустить, т. е. сравнение идет лучшему возможному качеству и скорости. RTX PRO с Qwen3.8-Flash-Next это где-то Opus 4.8 по общей оценке, Qwen3.8-27B где-то между Opus 4.6 и 4.7. Полез сравнивать результаты, и дальше оказалось куда интереснее:
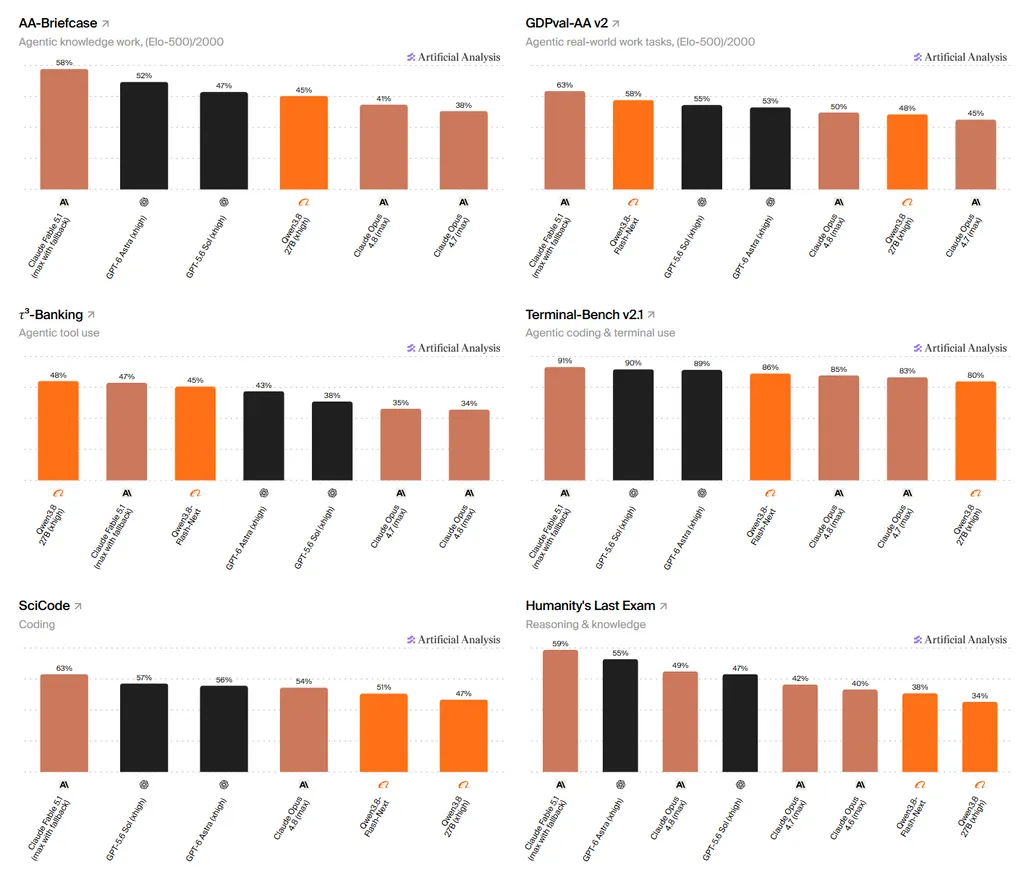
Общий уровень интеллекта хоть и выше у американских облаков, но большей частью за счет того, что Qwen заточен именно под кодирование:
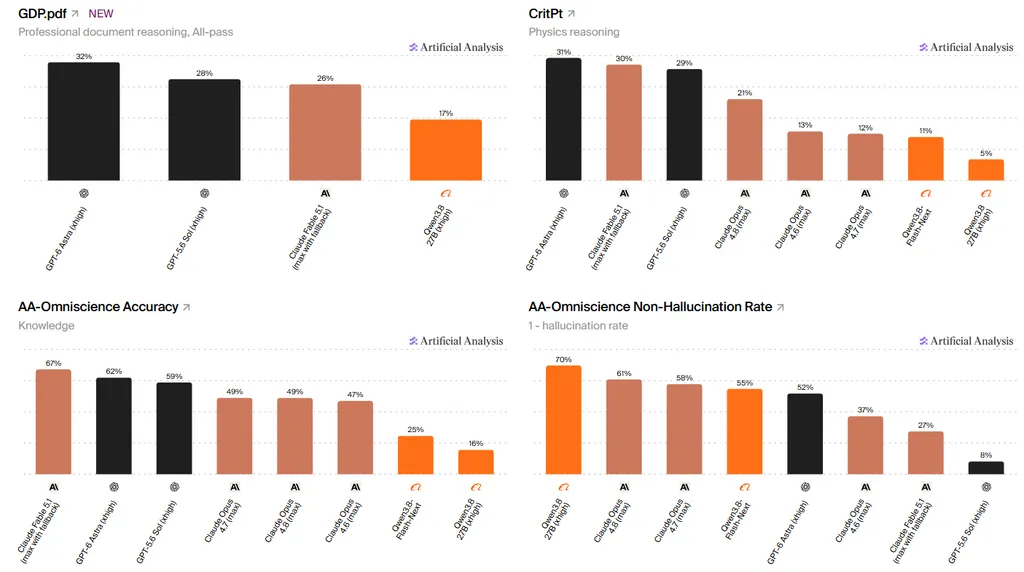
Смотрю я на графики GPT-6 и Fable-5.1 и вижу, что в задачах кодирования (SciCode) разница, конечно, в пользу облаков (увы, нет результатов Claude Opus 4.6 и 4.7 в базе), но она вообще не страшная. В агентских сценариях (GDPval-AA v2, 𝜏³-Banking? Terminal-Bench v2.1) или примерный паритет, или локальные модели где-то даже лидеры. С точки зрения галлюцинаций (AA-Omniscience Non-Hallucination Rate) опять же топовый уровень у открытых моделей.
Проигрыш в общей оценке идет полностью за счет научных бенчмарков и способности работать с документами. Да и общий уровень знаний хуже в разы, что не удивительно учитывая разницу в размере моделей в 1-2 порядка. Но какая разница для задач кодирования общего назначения? Скорее плюс Qwen в части умения сосредоточиться и выдать топовый результат в одной из самых интересных областей.
И всё это крутится на локальном железе с производительностью от весьма приемлемой до уровня «лучше чем в облаке».
Выглядит как то, что дела у проприетарных моделей не очень хороши и спасает их только лютый дефицит железа для локального использования. Но если тренд на повышение эффективности разработки будет расти и условный Senior сможет делать x5-x10 работы с моделями, то карты превращаются просто в профессиональный инструмент и порог входа не выше чем в работу в такси и аренду/покупку автомобиля.
Несколько выводов:
1) Оба варианта, положив руку на сердце, чумовые с точки зрения производительности. vLLM просто на голову превосходит llama.cpp, хотя и категорически не может работать с недостаточным объемом памяти и частичной выгрузкой в системную память хоть сколько-то адекватно.
2) Обе конфигурации дают адекватную реальным задачам производительность, особенно если активно использовать субагентов для Radeon, т. е. они не только контекст расширяют, но и позволяют забить GPU до полной сатурации матричных блоков (из-за этого многопоток быстрее)
3) Если сравнивать по чистой производительности (660 на 140-180 в пике, т. е. где-то 3,66x-4,7x в зависимости от контекста) в сравнении с ценой (2,8 млн. против 500 тыс. рублей, акции бы так на Мосбирже бы росли, т. е. 5,6х) Radeon существенно выгоднее, но если сравнивать с учетом комфорта работы (50-70 токенов в секунду на поток куда лучше 30, не считая количества потоков), то соотношение цен идеально рыночное. Главное иметь чем загрузить такую мощность.
4) Не вижу смысла лезть в облака и тратить нервы на обход блокировок, если есть финансовая возможность один раз вложиться в локальное железо и не иметь никаких лимитов и ограничений.
