Когда НЕ нужен ИИ-агент?
1. Введение: почему этот гайд стал каноном
Когда речь заходит об «агентах» поверх LLM, дискуссия мгновенно скатывается в маркетинг: каждый вендор обещает автономию, мульти-агентные рои и «AGI-уровень». На этом фоне статья Anthropic «Building effective agents» (декабрь 2024) стала тем самым опорным текстом, на который сегодня ссылаются почти все, кто проектирует агентные системы всерьёз.
Почему именно она стала каноном? Во-первых, она написана не теоретиками, а командой, которая строит и эксплуатирует агентов в продакшене и видит реальные счета за токены. Во-вторых, она даёт чёткий понятийный аппарат — разграничивает workflows и agents, а затем раскладывает по полочкам пять воспроизводимых паттернов. В-третьих, её главный посыл звучит контринтуитивно для хайпа: не усложняйте. Большинству задач достаточно одного хорошо составленного вызова модели с ретривалом и парой инструментов; полноценный автономный агент — это инструмент для узкого класса задач, а не дефолт.
Этот гайд — практический пересказ методологии для разработчиков: с определениями, схемами и псевдокодом, и главное — с ответом на вопрос «когда что применять».
2. Workflow vs Agent: определения и критерий выбора
Anthropic вводит ключевое различие. Оба понятия — это «агентные системы» (agentic systems) в широком смысле, но архитектурно они противоположны.
- Workflow (воркфлоу) — это система, где LLM и инструменты оркеструются по заранее заданным путям кода. Разработчик прописывает, какие шаги в каком порядке выполняются; модель заполняет шаги, но не управляет общим потоком. Поток детерминирован на уровне структуры.
- Agent (агент) — это система, где LLM динамически направляет собственный процесс и использование инструментов, сохраняя контроль над тем, как решается задача. Маршрут заранее не известен; модель сама в цикле решает, что делать дальше, опираясь на обратную связь от окружения.
Разница не в «уме» модели, а в том, кто держит управляющий поток: ваш код (workflow) или сама модель (agent).
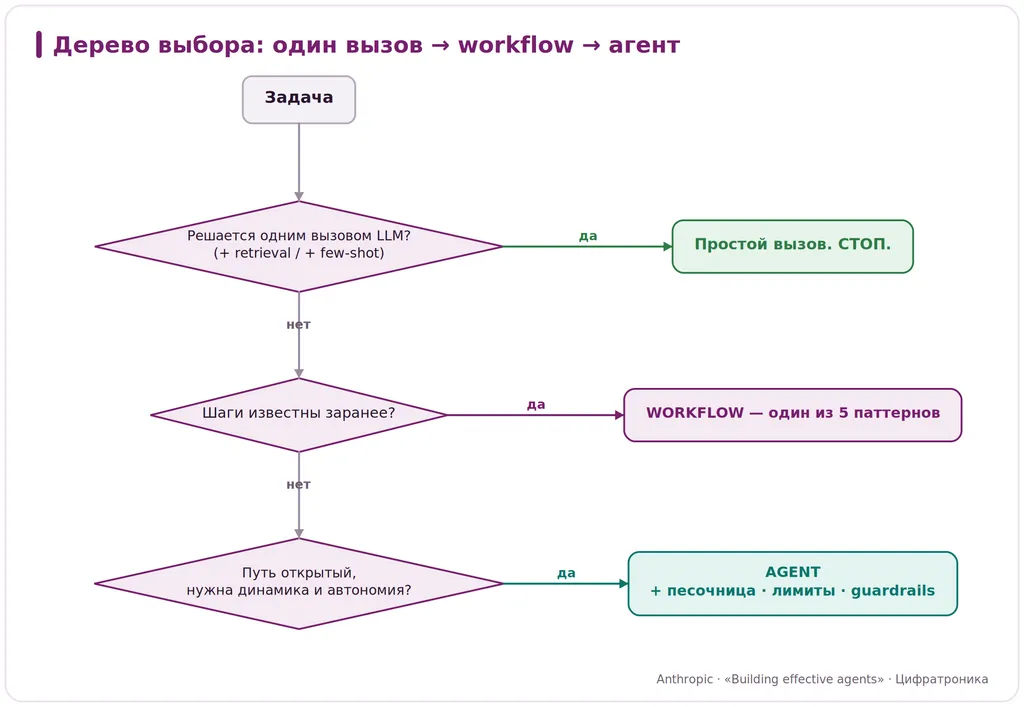
Критерий выбора у Anthropic предельно прагматичен и сводится к принципу «начинай с простого»:
- Сначала спросите, нужна ли вообще агентная система. Если задачу решает один оптимизированный вызов LLM с ретривалом и примерами в контексте — остановитесь здесь. Это самый дешёвый и предсказуемый вариант.
- Если одного вызова мало, но последовательность шагов известна заранее — берите workflow. Предсказуемость, низкая стоимость, простая отладка.
- Переходите к автономному агенту только когда нужна гибкость и принятие решений на основе модели в масштабе, а путь к решению невозможно жёстко прописать заранее.
Главная мысль: агенты дают гибкость ценой латентности, стоимости и риска накопления ошибок. Это осознанный размен, а не бесплатное улучшение.
Отдельно стоит развеять частую путаницу. «Workflow» в смысле Anthropic — это не обязательно тяжёлый BPM-движок или визуальный конструктор. Это просто факт, что управляющая логика живёт в вашем коде: обычный if/else, цикл for, вызовы функций, между которыми вставлены вызовы LLM. С другой стороны, «agent» — это не обязательно что-то огромное; минимальный агент — это цикл while, внутри которого модель смотрит на результат предыдущего действия и решает следующее. Граница проходит ровно по тому, записан ли маршрут в коде или формируется моделью на лету. Многие реальные системы — гибриды: воркфлоу-каркас, внутри одного из шагов которого крутится небольшой агент. Это нормально и часто оптимально.
3. Building block: augmented LLM
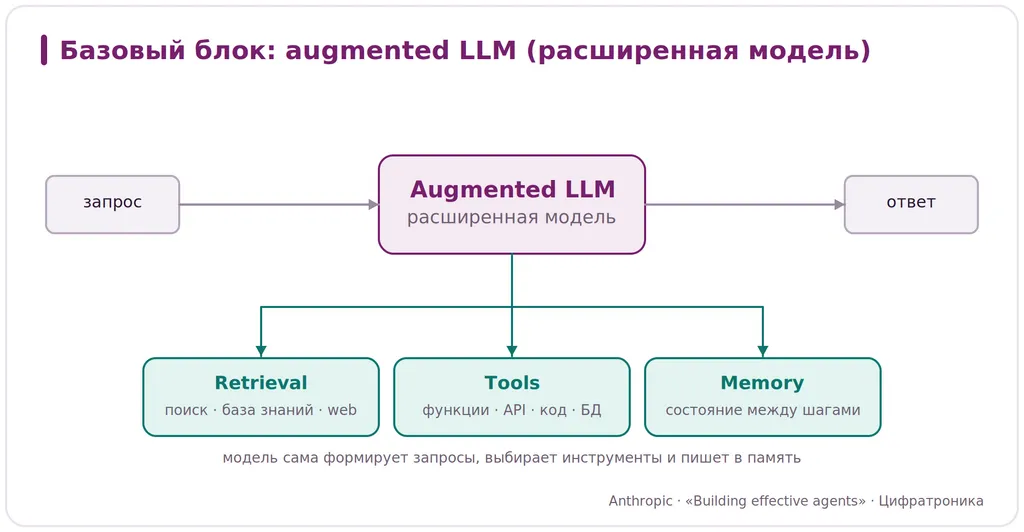
Прежде чем собирать паттерны, Anthropic определяет базовый кирпичик всех агентных систем — augmented LLM (расширенная модель). Это модель, дополненная тремя возможностями:
- Retrieval (ретривал) — модель может подтянуть релевантную информацию (поиск по базе знаний, документам, web) и опереться на неё вместо галлюцинаций.
- Tools (инструменты) — модель может вызывать внешние функции/API: поиск, выполнение кода, запросы к БД, отправку сообщений.
- Memory (память) — модель может сохранять и извлекать состояние между шагами и сессиями.
Важно: модель сама генерирует свои поисковые запросы, выбирает инструменты и решает, что положить в память. Все последующие паттерны — это разные способы скомпоновать такие расширенные блоки.
Галлюцинации ИИ — это логические ошибки генеративных нейросетей, при которых модель с абсолютной уверенностью выдает вымышленную, недостоверную или абсурдную информацию, выдавая ее за правдивый факт.
Главные причины
Принцип работы (статистическое предсказание): ИИ не «думает» и не проверяет факты по энциклопедиям. Его задача — предсказать следующее наиболее вероятное слово в предложении на основе данных из интернета.
Пробелы в обучении: Если модель не знает точного ответа, она скомпилирует «правдоподобный» ответ из похожих фрагментов текста, не отделяя реальность от вымысла.
Ненадежность источников: ИИ обучается на миллионах текстов из Сети, включая фейки, устаревшие данные и слухи. [1, 2, 3, 4]
Основные виды галлюцинаций
Фактические ошибки: Выдуманные даты, несуществующие ссылки на исследования, перепутанные имена ученых или исторические события.
Сфабрикованные цитаты: Уверенные утверждения, что известный человек сказал то, чего он никогда не произносил.
Логический абсурд: Грамотно написанный и убедительный текст, который полностью лишен логики или физического смысла.
Anthropic отдельно подчёркивает два инженерных приоритета на уровне базового блока:
- Заточите расширения под ваш конкретный use case. Не подключайте «всё подряд»; дайте модели ровно те инструменты и тот ретривал, что нужны. Лишний инструмент — это не только риск неверного выбора, но и расход контекста на его описание.
- Вложитесь в интерфейс между моделью и инструментами. Это та же дисциплина, что UX, только для модели — про неё подробно в разделе 6.
Почему augmented LLM важно осознавать как отдельный уровень: очень многие задачи, которые на словах звучат как «нам нужен агент», на деле решаются именно здесь — один вызов модели с подключённым ретривалом и двумя-тремя инструментами. Прежде чем строить любой из паттернов ниже, честно проверьте, не достаточно ли хорошо настроенного augmented LLM. Это самый дешёвый, самый предсказуемый и самый легко тестируемый вариант, и именно с него рекомендует начинать Anthropic.
4. Пять паттернов workflow
Это ядро методологии. Все пять — это workflow (управляющий поток в коде), но с разным устройством. Названия и семантику стоит держать точно — это канон.
4.1 Prompt chaining (цепочка промптов)
Что это. Задача разбивается на фиксированную последовательность шагов; каждый вызов LLM обрабатывает выход предыдущего. Между шагами можно ставить программные проверки («gate») — если промежуточный результат не прошёл проверку, цепочка останавливается или уходит на доработку.
Когда применять. Когда задачу можно чисто декомпозировать на предсказуемые подзадачи. Классика: «сгенерировать текст → перевести его на другой язык», «составить план → написать по плану документ». Вы жертвуете латентностью (шаги последовательны) ради точности каждого отдельного шага.
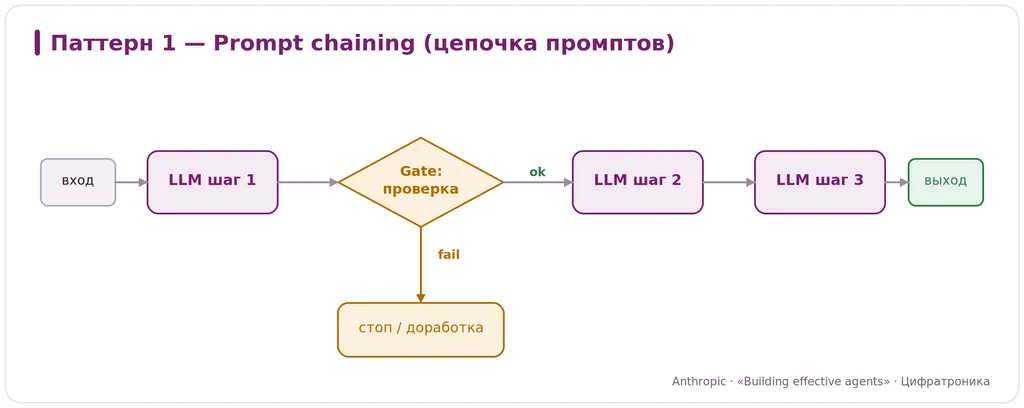
На что смотреть. Цепочка хороша ровно настолько, насколько надёжны её gate-проверки: программная валидация между шагами ловит ошибку до того, как она утечёт дальше по конвейеру. Не растягивайте цепочку без нужды — каждый шаг добавляет латентность и ещё одну точку отказа.
4.2 Routing (маршрутизация)
Что это. Первый вызов LLM классифицирует вход и направляет его на один из специализированных последующих процессов (или специализированный промпт/модель). Разделение задач позволяет затачивать каждую ветку отдельно.
Когда применять. Когда есть отчётливо разные категории входов, которые лучше обрабатывать по-разному, и классификацию можно сделать надёжно. Примеры: разные типы запросов в поддержку (возврат, технический вопрос, биллинг) → разные ветки; маршрутизация простых вопросов на дешёвую модель, сложных — на дорогую (оптимизация стоимости).
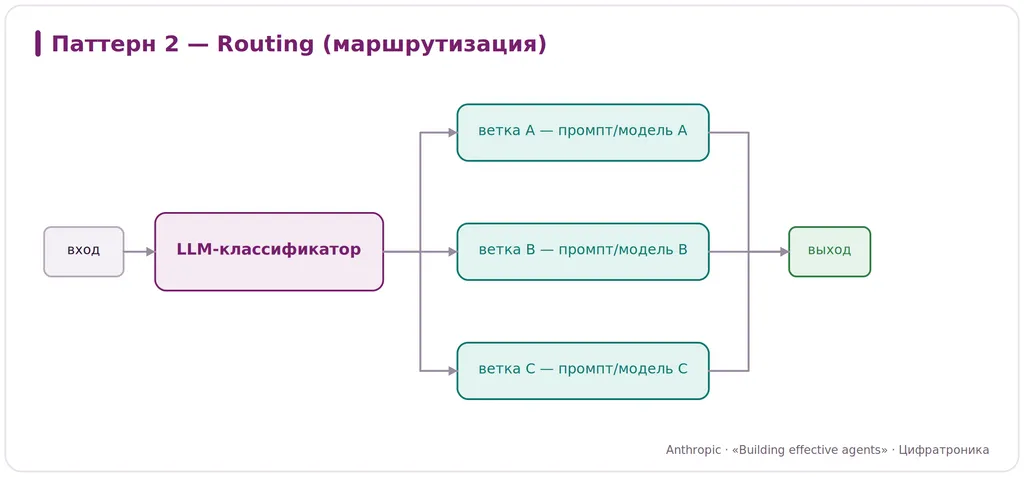
На что смотреть. Качество всего паттерна упирается в качество классификатора: ошибочная маршрутизация отправит запрос не в ту ветку, и пользователь получит нерелевантный ответ. Заведите явную ветку «не уверен / прочее» вместо того, чтобы заставлять классификатор гадать, и логируйте распределение по категориям, чтобы видеть перекосы.
4.3 Parallelization (параллелизация): sectioning и voting
Что это. Несколько вызовов LLM работают одновременно, их результаты затем агрегируются. У паттерна два подвида:
- Sectioning (секционирование) — задача разбивается на независимые подзадачи, которые считаются параллельно, а потом собираются. Пример: один вызов отвечает пользователю, другой параллельно проверяет ввод на нарушение правил (guardrail).
- Voting (голосование) — одна и та же задача прогоняется несколько раз для получения разнообразных ответов, из которых выбирается лучший или принимается решение по большинству. Пример: несколько прогонов проверки кода на уязвимость с порогом «если хоть один нашёл — флаг».
Когда применять. Когда подзадачи независимы и их можно распараллелить ради скорости, либо когда нужна повышенная уверенность/покрытие за счёт нескольких попыток (voting).
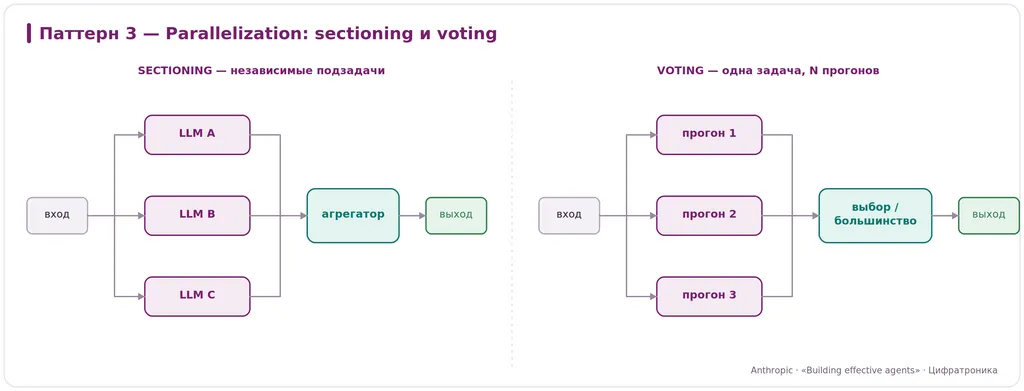
На что смотреть. Sectioning требует, чтобы подзадачи были действительно независимы — иначе агрегатор будет склеивать несогласованные куски. Для voting заранее определите правило агрегации (большинство, «хотя бы один сигнал», взвешенное голосование) — оно должно отражать цену ошибки: для guardrail по безопасности разумно «флаг, если хоть один прогон нашёл проблему».
4.4 Orchestrator-workers (оркестратор — исполнители)
Что это. Центральный LLM-оркестратор динамически разбивает задачу на подзадачи, делегирует их LLM-воркерам и затем синтезирует их результаты. Ключевое отличие от параллелизации: здесь подзадачи не зафиксированы заранее — оркестратор определяет их на лету, исходя из конкретного входа.
Когда применять. Когда нельзя предсказать заранее, на какие именно подзадачи разобьётся работа. Канонический пример из практики Anthropic — функция Research: ведущий агент вырабатывает стратегию и порождает специализированных субагентов под конкретный запрос (см. «How we built our multi-agent research system»). Другой пример — изменения в коде, затрагивающие непредсказуемый набор файлов.
Обратите внимание: orchestrator-workers — это уже мостик к агентам. Динамическая декомпозиция делает поток менее предопределённым. Подробнее про оркестрацию нескольких агентов распишем в будущих статьях.
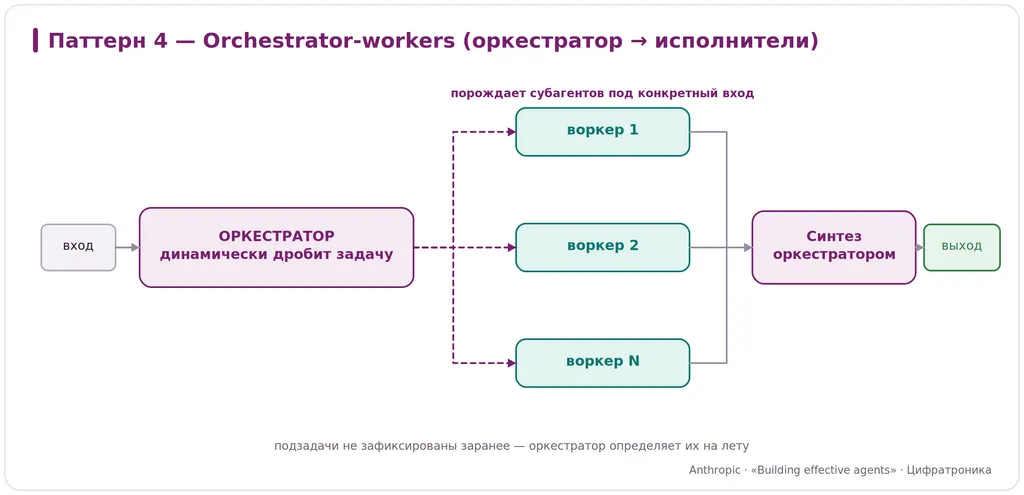
На что смотреть. Сила паттерна — динамическая декомпозиция — она же его главный риск: оркестратор может породить слишком много воркеров и взорвать бюджет токенов. Поэтому масштабируйте усилие под сложность запроса (несколько вызовов на простой, десятки воркеров на действительно сложный) и закладывайте лимиты. Учите оркестратор делегировать чётко: каждому воркеру — ясная цель, формат вывода и границы, иначе результаты будет нечем синтезировать.
4.5 Evaluator-optimizer (генератор — оценщик)
Что это. Один вызов LLM генерирует ответ, второй вызов LLM оценивает его и даёт обратную связь; цикл повторяется, пока оценщик не сочтёт результат достаточно хорошим. По сути — итеративная петля «генерация → критика → улучшение».
Когда применять. Когда есть чёткие критерии качества и итеративная доработка измеримо улучшает результат, причём фидбэк LLM-оценщика реально полезен (аналогия — как человек-редактор улучшает текст за несколько проходов). Примеры: литературный перевод с нюансами, многошаговый поиск, где оценщик решает, нужны ли ещё раунды.
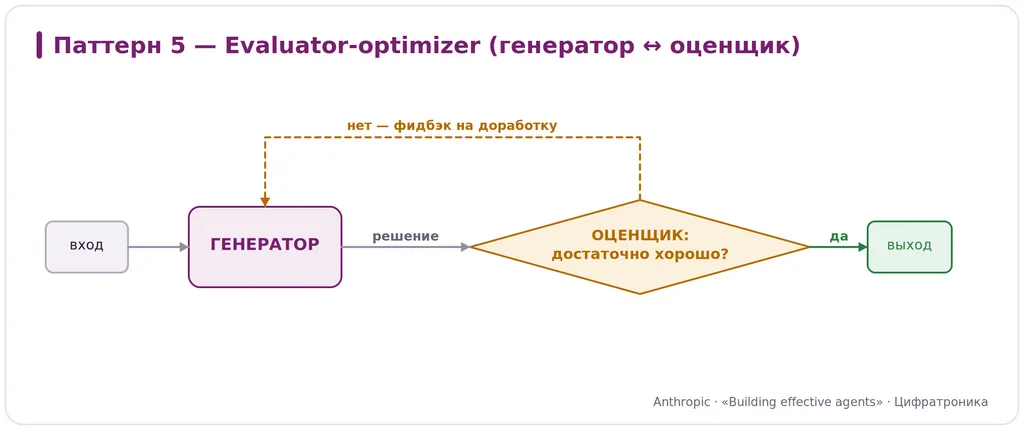
На что смотреть. Паттерн оправдан, только если фидбэк оценщика действительно полезен и критерии измеримы — иначе вы просто платите за лишние раунды без улучшения. Обязательно ставьте предел числа итераций: без него петля может крутиться бесконечно или «ходить по кругу», переписывая ответ без прогресса.
5. Когда переходить к автономному агенту
Автономный агент — это не «улучшенный workflow», а другой режим работы. Anthropic описывает его так: агент начинает с команды или диалога от человека, затем планирует и действует самостоятельно в цикле, на каждом шаге получая обратную связь от окружения (результат выполнения инструмента, ошибку, состояние среды) и опираясь на неё для следующего шага. Цикл продолжается до достижения цели или до условия остановки (например, лимита итераций). При необходимости агент может приостанавливаться для проверки человеком (checkpoint).
Признаки задачи, где оправдан автономный агент:
- путь к решению открытый и непредсказуемый, его нельзя жёстко прописать;
- число шагов заранее неизвестно, и нельзя зашить фиксированный поток;
- задача требует гибкого принятия решений в масштабе, где модель должна сама выбирать инструменты;
- есть надёжный способ верифицировать прогресс (тесты, проверка окружения), чтобы агент не «улетал» в галлюцинации.
Цена и риски, которые надо заложить. По замерам Anthropic, агенты тратят примерно в 4 раза больше токенов, чем обычный чат, а мульти-агентные системы — около 15 раз больше. Ошибки в цикле каскадируют: неверный шаг тянет за собой следующие. Поэтому автономный агент требует:
- песочницы (sandbox) для выполнения действий без вреда продакшену;
- guardrails и лимитов (бюджет токенов, максимум итераций, белые списки инструментов);
- полной трассировки — без неё отладку каскадных ошибок не провести;
- точек контроля человеком на критичных действиях.
Для длительных автономных задач, не влезающих в одно контекстное окно, отдельная инженерия — harness (каркас): структура состояния, артефакты прогресса, восстановление после ошибок. Об этом — отдельный канонический разбор Anthropic «Effective harnesses for long-running agents»: роли Initializer/Coding Agent, JSON-список фич (изначально все «не выполнены», чтобы избежать преждевременных заявлений о готовности), progress-файл, интеграция с git и health-checks при старте сессии. Вывод там созвучен основному гайду: человеческие инженерные практики напрямую улучшают автономную работу агента.
6. Практические принципы
Anthropic сводит весь опыт к трём сквозным принципам, которые применимы к любому из паттернов.
1. Простота (simplicity). Начинайте с минимально достаточного решения и добавляйте сложность только при доказанной необходимости. Каждый дополнительный слой (агентность, мульти-агентность, лишние инструменты) — это рост латентности, стоимости и поверхности для ошибок. «Самая успешная агентная система» — не самая навороченная, а самая подходящая под задачу.
2. Прозрачность (transparency). Явно показывайте шаги планирования и решения агента. Если поток непрозрачен, вы не сможете ни отладить его, ни доверить ему ответственные действия. Это особенно критично с точки зрения ИБ: непрозрачный автономный агент с доступом к инструментам — это риск, который нельзя проконтролировать. Логируйте и трассируйте каждый вызов инструмента.
3. Хороший интерфейс агент–компьютер (ACI, agent-computer interface). Anthropic настаивает: проектированию инструментов нужно уделять столько же сил, сколько UX для людей. Практические советы:
- пишите понятную документацию к каждому инструменту, давайте примеры использования и граничные случаи;
- выбирайте форматы, которые модели «удобно» генерировать (меньше экранирования, естественные для текста структуры);
- делайте инструменты «защищёнными от ошибок» (poka-yoke) — так, чтобы их трудно было применить неправильно;
- тестируйте инструменты на реальных вызовах модели и итерируйте по наблюдаемым ошибкам.
И в дополнение к этим трём — измеряйте и итерируйте. Заведите небольшой набор тестовых сценариев (eval), смотрите на реальное поведение, и только данные, а не интуиция, пусть решают, нужен ли следующий слой сложности.
7. Мини-кейс: выбор паттерна
Представим типичную для нашего профиля (нейросети + ИБ) задачу: «автоматизировать первичный разбор входящих сообщений в баг-баунти / security-инбоксе». Прогоним её через дерево решений.
- Один вызов LLM хватит? Нет — нужно и классифицировать, и проверить вложения, и при необходимости запросить артефакты.
- Шаги известны заранее? В целом да. Значит, workflow, а не автономный агент. Уже здесь мы сэкономили: не строим дорогую автономию там, где она не нужна.
Теперь компонуем паттерны:
- Routing на входе: классифицируем сообщение — это новый отчёт об уязвимости, дубликат, спам или вопрос? Каждая категория уходит в свою ветку.
- Parallelization (sectioning) в ветке «новый отчёт»: параллельно (а) извлекаем структуру отчёта (тип уязвимости, затронутый компонент) и (б) прогоняем guardrail-проверку на вредоносные ссылки/вложения. Независимые подзадачи — отлично ложатся на параллель.
- Prompt chaining для формирования ответа: шаг 1 — черновик резюме отчёта, gate-проверка полноты обязательных полей, шаг 2 — формулировка ответа репортёру и предложенного severity.
- Evaluator-optimizer на чувствительном шаге определения severity: генератор предлагает оценку и обоснование, оценщик сверяет с рубрикой (CVSS-критерии) и возвращает на доработку, если обоснование неполное.
Заметьте: мы не взяли «одного большого автономного агента». Мы собрали предсказуемый, дешёвый и легко аудируемый конвейер из четырёх паттернов. Автономный агент здесь оправдан был бы только для открытой подзадачи — например, «самостоятельно воспроизвести уязвимость в песочнице», где путь заранее неизвестен; и то — строго в sandbox с лимитами и трассировкой.
Что это даёт на практике. Каждый шаг конвейера наблюдаем и тестируется отдельно: для классификатора (routing) можно собрать набор размеченных сообщений и мерить точность; для шага severity (evaluator-optimizer) — сверять с эталонными оценками безопасников. Если завтра появится новая категория входящих, мы добавим ветку в routing, не трогая остальное. Если оценка severity «поплывёт», мы поправим рубрику оценщика, а не будем переучивать монолитного агента. Именно эта модульность и отлаживаемость — практическая выгода от того, что мы остались в парадигме workflow там, где она достаточна. И с точки зрения ИБ это критично: аудитор может пройти по конвейеру шаг за шагом и понять, где принимается каждое решение, — чего почти невозможно добиться от непрозрачного автономного агента.
8. Источники
- Anthropic, «Building effective agents» — https://www.anthropic.com/engineering/building-effective-agents (канонический первоисточник: workflow vs agent, пять паттернов, ACI, принцип простоты).
- Anthropic, «How we built our multi-agent research system» — https://www.anthropic.com/engineering/multi-agent-research-system (orchestrator-workers в продакшене, стоимость в токенах 4×/15×, уроки эксплуатации).
- Anthropic, «Effective harnesses for long-running agents» — https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents (каркас для длительных автономных задач, восстановление после ошибок, верификация).
